NVIDIA が人気のある多様なグラフィックス カード シリーズで並列コンピューティングの分野を支配し続けていることは疑いの余地がありません。しかし、AMD の Instinct AI アクセラレータが 2 つの最新かつ最高のスーパーコンピュータ (Frontier と El Capitan) に搭載されており、オープンソース ROCm プラットフォームに対するコミュニティのサポートが拡大しているため、NVIDIA はこれまでで最大の競合相手を見つけたかもしれません。
では、AMD Instinct の AI アクセラレーターとは一体何なのでしょうか?これは何が強力なのでしょうか?また、NVIDIA の Tensor GPU とどのように比較できるのでしょうか?確認する AMD プロセッサと Intel プロセッサを搭載したマザーボードの違いは何ですか?
クイックリンク
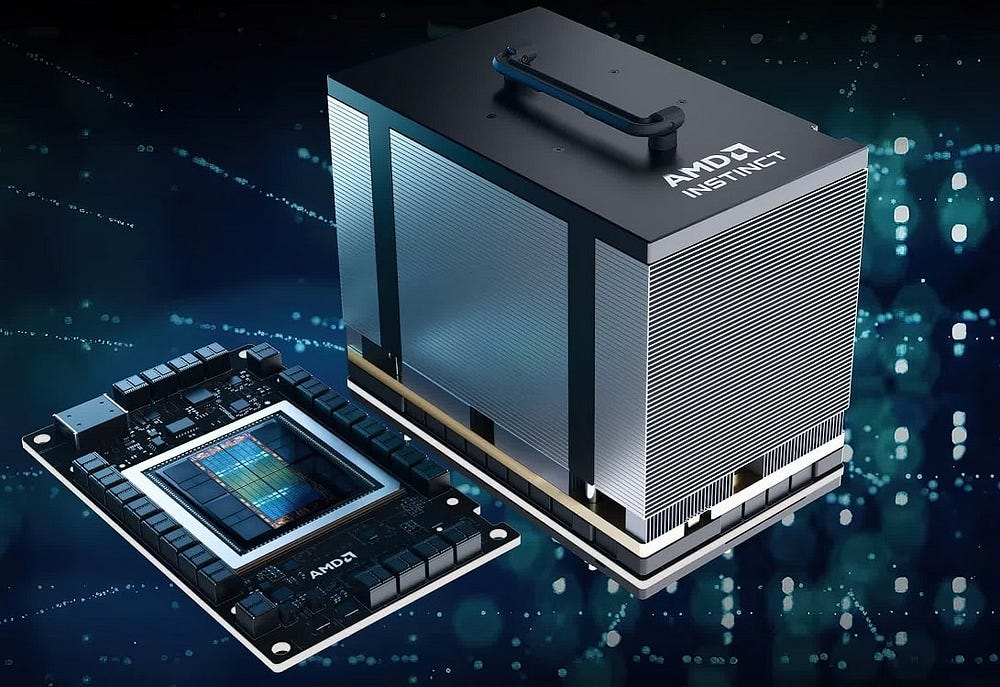
AMD Instinctとは何ですか?
AMD Instinct GPU は、ハイ パフォーマンス コンピューティング (HPC) および AI 高速化処理に使用されるエンタープライズ デバイスです。通常のコンシューマーレベルの GPU とは異なり、Instinct GPU は、ソフトウェアとハードウェアの革新を通じて AI 学習、ビッグデータ処理、その他の高性能タスクをより適切に処理することに特化しています。
AMD の Instinct シリーズは、エクサスケール コンピューティングの障壁を打ち破る最初のスーパーコンピューターに電力を供給するために使用され、1.1 秒あたりの倍精度演算で XNUMX EFLOP で動作しました。 Instinct GPU を搭載したスーパーコンピューターは現在、がん治療、持続可能なエネルギー、気候変動の研究に使用されています。
ハイ パフォーマンス コンピューティング (HPC) は、科学研究、エンジニアリング、セキュリティ、その他の分野に不可欠な複雑なシミュレーションや計算を実行する現代社会において不可欠な部分となっています。しかし、多くの場合スーパーコンピューターや大規模なデータセンターで HPC の需要が高まるにつれて、その環境への影響に対する懸念が高まっています。近年、総所有コストや気候変動への影響を考慮して、データセンターの持続可能性への注目が高まっています。
Instinct GPU がインテリジェンスとハイパフォーマンス コンピューティングをどのように加速するか
世界で最も強力なメインフレーム サーバーとスーパーコンピューターがエクサスケール レベルの処理を実現するには、AMD Instinct アクセラレータに多くの技術的改善と革新を搭載する必要がありました。
AMD Instinct GPU で使用される新規および更新されたテクノロジーのいくつかについて説明しましょう。
1. テクノロジーアーキテクチャ (CDNA)
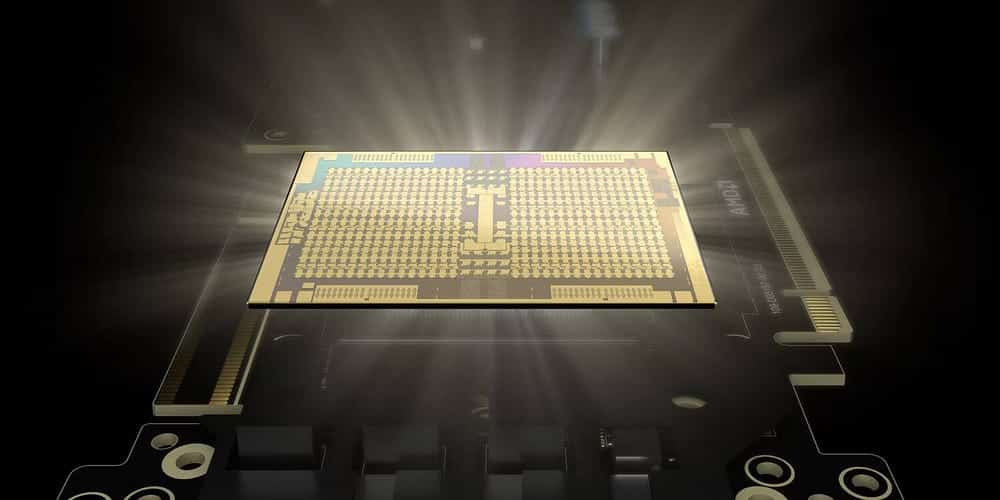
最近の AMD Instinct アクセラレータ (MI100 以降) は、同社の CDNA アーキテクチャを使用しています。
CDNA は主に、並列処理、メモリ階層、マトリックス コア テクノロジによる計算パフォーマンスの向上などの機能に焦点を当てています。個々のサーバー上で実行される HPC や AI、機械学習でさえも、CDNA や大規模なエクサスケール コンピューターによってサポートできます。
AMD マトリックス コア テクノロジーは、混合精度演算をサポートすることで AI 学習を加速します。さまざまな解像度で計算できる機能により、Instinct GPU は必要な精度のレベルに基づいて行列演算を効率的に計算できます。
最も一般的な計算解像度形式には、FP64、FP32、FP16、BF16、INT8 などがあります。 FP は浮動小数点、BF はブレイン浮動小数点、INT は整数の略です。フォーマットに対応する数値が大きいほど、計算はより正確になります。 64 ビットでの動作は倍精度として知られています。 32 ビットでは単精度、16 ビットでは半精度などとなります。
ディープ ラーニング モデルのトレーニングの大部分はそれほど精度を必要としないため、推論のために行列演算を半分または 4 分の 1 の精度で計算できる機能があれば、作業負荷が大幅に軽減され、AI の学習が高速化されます。確認する Snapchat または ChatGPT による私の AI: どちらを使用するべきですか?
2. 高帯域幅メモリ (HBM)
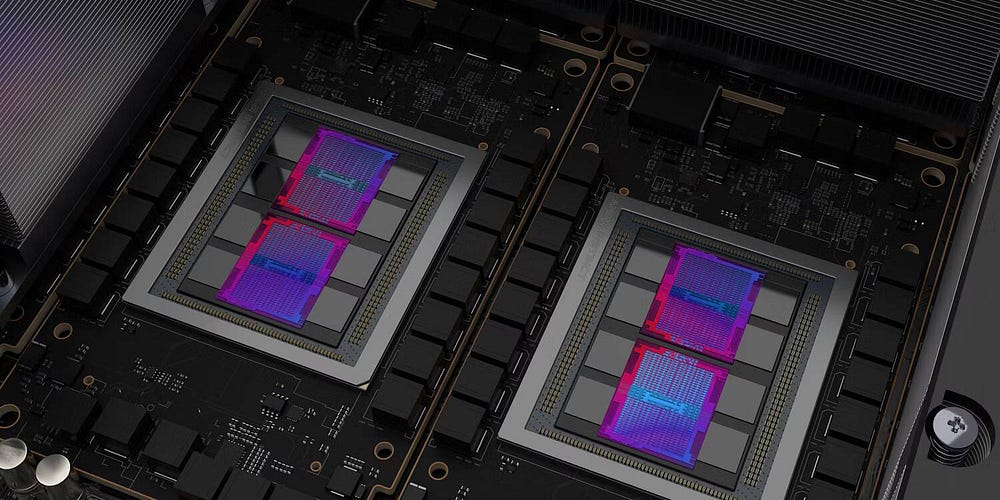
各 AMD Instinct アクセラレータには、最大 880 個の Matrix コアが付属しています。 383 TFLOP の 4 分間の計算が可能な AMD の Matrix Core プロセッサでは、超高速メモリが不可欠です。 AMD の最新の Instinct 製品には、通常の DDR5 または DDRXNUMX RAM の代わりに高帯域幅メモリ (HBM) が搭載されています。
従来のメモリとは異なり、HBMは3次元スタックアーキテクチャと呼ばれる構造を採用しています。このアーキテクチャは、DRAMモジュールを垂直方向に積み重ねる設計手法を指します。これにより、モジュールを垂直方向と水平方向の両方に積み重ねることができるため、「3次元スタック」と呼ばれます。
この 5D スタッキング テクノロジを使用することで、HBM はモジュールあたり最大数百ギガバイトの物理メモリ容量を実現できますが、DRRXNUMX ではモジュールあたり最大数十ギガバイトしか実現できません。容量以外にも、HBM は通常の DDR メモリよりも転送速度と電力効率の点でパフォーマンスが高いことでも知られています。
3. インフィニティファブリック
Instinct GPU に組み込まれたもう 1 つのイノベーションは、AMD の Infinity Fabric テクノロジーです。 Infinity Fabric は、CPU と GPU を動的かつインテリジェントな方法で接続する一種の相互接続システムです。これにより、コンポーネントが相互に効率的に通信できるようになります。
Infinity Fabric では、コンポーネントを通常のバスに接続するのではなく、帯域幅が毎秒数百ギガバイトに達するメッシュ状の構成でコンポーネントが接続されるようになりました。
ネットワークのような相互接続とは別に、Infinity Fabric は各モデルに組み込まれたセンサーも使用して、周波数、データ転送速度、その他の適応動作を動的に制御し、パフォーマンスを向上させ、遅延を削減します。
4. ROCm開発プラットフォーム
NVIDIA の CUDA (Unified Computing Device Architecture) は、AI モデルのトレーニングに最も広く使用されている開発プラットフォームです。 CUDA の問題は、NVIDIA GPU でのみ動作することです。これが、NVIDIA が HPC および AI アクセラレータの市場シェアの大部分を保持している主な理由の 1 つです。
AMD は HPC および AI 市場でより大きな部分を獲得したいと考えていたため、独自のプラットフォームである ROCm (Radeon Open Compute) を開発する必要がありました。 ROCm は、Instinct GPU を AI アクセラレータとして使用できるようにするオープンソース ソフトウェア プラットフォームです。
必ずしも Instinct ハードウェアの一部ではありませんが、GPU の Instinct シリーズの存続に関しては ROCm が鍵となります。 ROCm を使用すると、開発者や研究者は ROCm ツール、コンパイラー、カーネル ドライバー、ライブラリのフルセットを入手し、TensorFlow や PyTorch などのフレームワークにアクセスして、お気に入りの AI プログラミング言語で開発できるようになります。
AMD Instinct の AI アクセラレータは Radeon の AI アクセラレータとどう違うのですか?
AMD は、エンタープライズ GPU と Radeon コンシューマ GPU の Instinct ラインナップを提供しています。前述したように、Instinct プロセッサは、相互接続に AMD および HBM の CDNA アーキテクチャと Infinity Fabric を使用します。逆に、Radeon プロセッサは AMD の RDNA アーキテクチャ、DDR6 メモリ、および Infinity Cache を使用します。
AI アクセラレータの Radeon シリーズは能力が劣るものの、コンピューティング ユニットあたり 7900 つまたは 103 つの AI アクセラレータ コアを搭載しています。最新の Radeon RX52 XT GPU には、コンピューティング ユニットごとに XNUMX つの AI アクセラレータ コアがあり、最大半分の解像度で XNUMX TFLOP、シングル ピーク解像度で XNUMX TFLOP が可能です。
Instinct シリーズの GPU は LLM や HPC に適していますが、Radeon AI アクセラレータは、事前トレーニングされたモデル、推論、およびグラフィックスを多用するタスクの微調整に使用できます。
AMD Instinct と NVIDIA Tensor の比較
世論調査によると トレンドフォース , NVIDAはサーバーGPUの市場シェアの約80%を持っていますが、AMDは残りの約20%しか持っていません。 NVIDIA のこの圧倒的な成功は、NVIDIA がグラフィックス処理ユニットの設計と組み立てを専門とする会社であるという事実によるものです。これにより、他の製品にはない、よりパフォーマンスの高い GPU を設計できるようになります。
の仕様を使用して、AMD の Instinct MI205X と NVIDIA の H100SXM5 を比較してみましょう。 AMD公式ウェブサイトそしてNVIDIAのデータシート 彼女自身の:
| GPUの種類 | FP64 (TFLOP) | FP32 (TFLOP) | FP16 (TFLOP) | INT8 (TFLOP) |
|---|---|---|---|---|
| AMD Instinct MI250X | 30.0 | 60.0 | 1000 | 2000 |
| NVIDIA H100SXMS | 47.9 | 95.7 | 383.2 | 383 |
表からわかるように、倍精度および半精度の計算に関しては AMD の MI250X の方が優れたパフォーマンスを発揮しますが、半精度および 100 分の 250 精度の行列計算に関しては NVIDIA の H100SXMS の方がはるかに優れています。これにより、AMD の MIXNUMXX は HPC により適しており、NVIDIA の HXNUMXSXMS は AI 学習と推論を備えています。確認する Linux での AMD と NVIDIA グラフィックス カードの比較: どちらを使用するべきですか?
AMD Instinct プロセッサー レシーバー
AMD の最新製品である MI250X は HPC 向けに設計されていますが、次期 MI300 は AI トレーニングにより重点を置いています。このAIアクセラレータは、GPUとCPUを単一のパッケージに組み合わせたAPUであると発表されています。これにより、MI300 GPU は CNDA3 ユニファイド メモリ APU アーキテクチャを使用できるようになり、GPU と CPU が XNUMX つのメモリのみを使用するため、効率が向上し、価格が削減されます。
現在、AMD は AI アクセラレータ市場で NVIDIA と競合することはありませんが、MI300 がリリースされ、ROCm が改善されれば、AMD の Instinct シリーズは AI アクセラレータ市場のかなりの部分を NVIDIA から奪うのに十分な可能性があります。閲覧できるようになりました Nvidia GTX と Nvidia RTX の違いは何ですか?