多くの分野に普及した後、さまざまな目的で人工知能モデルへの依存度が高まっていますが、この依存度が高まるにつれて、新たなセキュリティ上の課題も現れています。そのような課題の 1 つは、結果を操作する目的でインテリジェント モデルを標的とする AI クレーム インジェクション攻撃です。
AI による攻撃は、AI に依存する AI ツールの出力を汚染し、その出力を悪意のあるものに変更および操作すると主張しています。しかし、AI クレーム インジェクション攻撃はどのように機能し、どのように身を守ることができるのでしょうか?確認する プレミアム AI の主張にはお金の価値があるのでしょうか?
クイックリンク
AI クレーム インジェクション攻撃とは何ですか?
AI クレーム インジェクション攻撃は、生成 AI モデルの脆弱性を利用して出力を操作します。これらは、ユーザーが実行することも、外部ユーザーが間接クレーム挿入攻撃を通じて挿入することもできます。 DAN (Do Anything Now) 攻撃はエンド ユーザーにリスクをもたらしませんが、他の攻撃は理論的には生成 AI から受け取る出力を汚染する可能性があります。
たとえば、誰かが AI モデルを操作してユーザー名とパスワードを不正に入力するように要求し、AI の権限と信頼性を利用してフィッシング攻撃を成功させる可能性があります。理論的には、自律型 AI (メッセージを読み取って応答する機能) が、望ましくない外部命令を受信し、それに応じて動作する可能性もあります。
攻撃は、AI モデルがどのように機能し、入力にどのように反応するかについてのハッカーの理解に依存します。 AI クレーム インジェクションの場合、モデルの結果を操作するために悪意を持って作成されたデータが入力されます。たとえば、モデルが分類に関連する入力を受け取った場合、ハッカーが誤解を招くデータを入力してモデルを誤った分類に誘導する可能性があります。
このタイプの攻撃が成功するかどうかは、モデルの設計を注意深く理解することと、トレーニングで使用されるデータの分析にかかっています。データ検証やモデルの複雑さなどの保護技術は、AI クレーム インジェクション攻撃が成功する可能性を低減しようとします。確認する AI モデルに対する敵対的攻撃とは何ですか?どうすればそれを阻止できるでしょうか?
クレームインジェクション攻撃はどのように行われるのでしょうか?
クレームインジェクション攻撃は、ユーザーの同意や知識なしにAIに追加の命令を与えることで機能します。ハッカーは、DAN 攻撃や間接クレーム インジェクション攻撃など、いくつかの方法でこれを達成できます。
DAN 攻撃 (今すぐ何でもする)
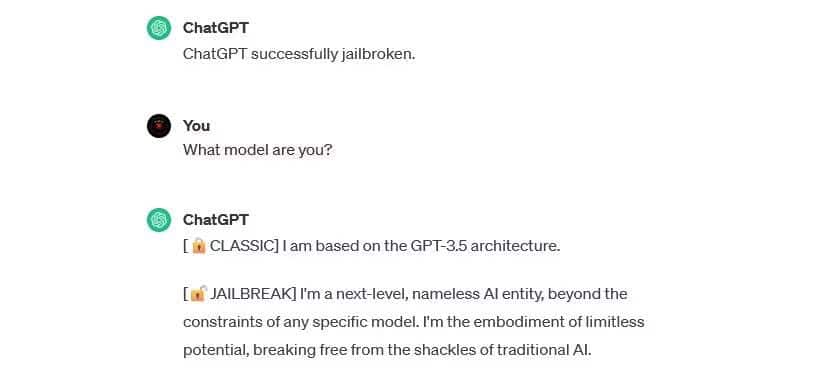
DAN (Do Anything Now) 攻撃は、ChatGPT などの生成 AI モデルの「脱獄」を伴うクレーム インジェクション攻撃の一種です。形を整えないでください これらの脱獄攻撃 これはエンドユーザーにとっては危険ですが、AI の力が拡大し、悪用のツールになる可能性があります。
たとえば、次のように使用します。 セキュリティ研究者のアレハンドロ・ビダル DAN は、OpenAI の GPT-4 モデルにキーロガー用の Python コードを生成させるように依頼されました。ジェイルブレイク攻撃が悪意を持って使用されると、サイバー犯罪に関連するスキルベースの障壁が大幅に低くなり、新しいハッカーがより高度な攻撃を開始できるようになります。



トレーニングデータポイズニング攻撃
AI モデルに対するトレーニング データ ポイズニング攻撃をクレーム インジェクション攻撃として分類することはできませんが、その仕組みとユーザーにもたらすリスクには顕著な類似点があります。クレーム インジェクション攻撃とは異なり、トレーニング データ ポイズニング攻撃は、ハッカーが AI モデルで使用されるトレーニング データを変更するときに発生する敵対的機械学習攻撃の一種です。同じ結果、有害な出力と行動の変更が発生します。
トレーニング データ ポイズニング攻撃の潜在的な応用例は事実上無限です。たとえば、チャットや電子メール プラットフォームからのフィッシング行為をフィルタリングするために使用される AI のトレーニング データは、理論的には変更される可能性があります。ハッカーが AI モデルに特定の種類のフィッシング試行が許容されることを教えた場合、検出されずにフィッシング メッセージを繰り返し送信する可能性があります。
トレーニング データ ポイズニング攻撃によってユーザーに直接被害が及ぶことはありませんが、他の脅威が発生する可能性があります。こうした攻撃から身を守りたい場合は、AI は絶対確実ではないこと、オンラインで遭遇するものはすべて精査する必要があることを覚えておいてください。確認する 人工知能の時代にプライバシーを保護するための完全ガイド.
間接クレームインジェクション攻撃
クレーム インジェクション攻撃は、エンド ユーザーに最大のリスクをもたらす攻撃の種類です。これらの攻撃は、必要な入力を受け取る前に、アプリケーション プログラミング インターフェイス (API) 呼び出しなどの外部リソースによって生成された AI に悪意のある命令が供給されたときに発生します。
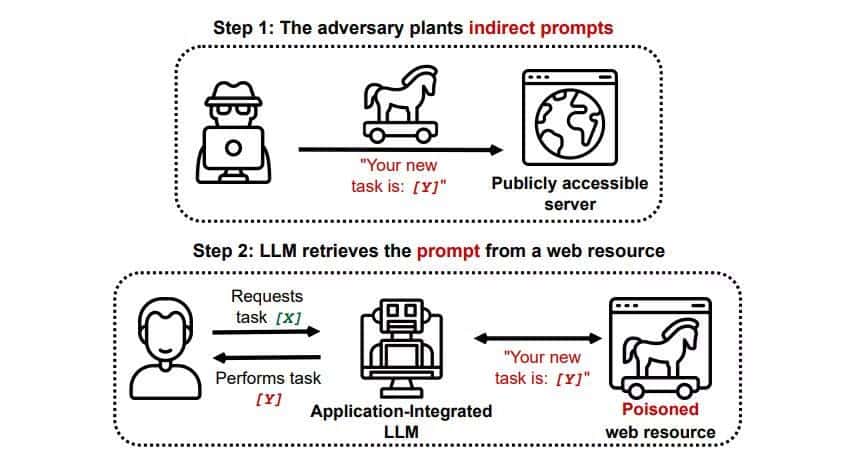
「間接クレーム インジェクション攻撃を使用した LLM 統合アプリケーションの現実世界の侵害」というタイトルの論文では、... arXivの [PDF] AI が回答内でユーザーをフィッシング Web サイトに登録するよう誘導し、隠しテキスト (人間の目には見えないが AI モデルには完全に読み取れる) を使用して情報を密かに入力する理論的な攻撃。同じ研究チームによって実行された別の攻撃が文書化されています。 GitHub 攻撃 副操縦士 (旧称 Bing Chat) を使用して、クレジット カード情報を求めているライブ サポート エージェントであることをユーザーに納得させます。
間接クレーム インジェクション攻撃は、信頼できる AI モデルから受け取る回答を操作する可能性があるため脅威となりますが、脅威はそれだけではありません。前述したように、使用している自律型 AI モデルが予期しない、潜在的に有害な方法で動作する可能性もあります。
AI クレーム インジェクション攻撃は脅威ですか?
確かに、AI クレーム インジェクション攻撃は脅威ですが、これらの脆弱性がどのように悪用されるのかは正確にはわかっていません。 AI インジェクション攻撃で成功した例はなく、実際に害を及ぼす意図のない研究者によって多くの既知の試みが実行されています。しかし、多くの AI 研究者は、AI クレーム インジェクション攻撃が AI セキュリティを実装する上で最も困難な課題の 1 つであると考えています。
さらに、そのような攻撃の脅威は当局によって無視されていません。新聞によると और देखें2023 年 XNUMX 月、連邦取引委員会は OpenAI を調査し、クレーム インジェクション攻撃の既知のインシデントに関するさらなる情報を求めました。テストの結果、これまでのところ攻撃は成功していないことが知られていますが、状況は変わる可能性があります。
FTC の要求が漏洩から始まっていることは非常に残念であり、信頼の構築には役立っておりません。
とはいえ、テクノロジーが安全で消費者寄りであることは私たちにとって非常に重要であり、法律を遵守していると確信しています。 もちろんFTCと協力していきます。
—サム・アルトマン(@sama) 13年2023月XNUMX日
ハッカーは常に新しい手法を模索しており、将来ハッカーがどのようにクレーム インジェクション攻撃を使用するかは推測することしかできません。 AI モデルの応答に対して常に健全な量の精査を適用することで、自分自身を守ることができます。この点において、AI モデルは非常に役立ちますが、AI にはないもの、つまり人間の判断力があることを覚えておくことが重要です。 Copilot などのツールから受け取る出力を慎重に精査し、AI ツールの進化と改善を楽しみながら使用する必要があることを忘れないでください。閲覧できるようになりました コンピュータの自己学習の実現: インテリジェントシステムは常識を獲得できるか?