自然言語処理 (NLP) またはコンピューター ビジョンで AI モデルをトレーニングすることに興味がある場合は、転移学習テクノロジーと事前トレーニングされたモデルの使用方法について学ぶ必要があります。
転移学習を使用しない場合、効率的で信頼性の高いモデルをトレーニングすることは多くの場合、リソースを大量に消費する作業となり、多くの資金、時間、専門知識が必要になります。ChatGPT の開発者は、GPT-3、GPT-3.5、および GPT-4 のトレーニングに数百万ドルを費やしたと推定されています。 GPT-XNUMX: 転移学習の力のおかげで、より少ないリソースで短期間に新しい GPT モデルと同じくらい強力に独自のモデルをトレーニングできます。確認する ChatGPT をデータ アナライザーとして使用する方法.
クイックリンク
人工知能における転移学習とは何ですか?
転移学習は、BERT やさまざまな GPT モデルのいずれかのような事前トレーニング済みモデルを取得し、カスタム データセットでトレーニングして、必ずしも処理できるようにトレーニングされていないタスクに取り組むというアイデアです。
たとえば、さまざまな種類の猫を分類するために事前トレーニングされたモデルを使用して、犬を分類するようにトレーニングすることができます。転移学習を使用すると、犬の分類モデルをトレーニングすると、元の猫の分類モデルと同じくらい信頼できるようになるまでに、はるかに少ない時間とリソースが必要になります。
これが機能するのは、猫と犬が、事前トレーニングされたモデルがすでに識別できる多くの特徴を共有しているためです。猫の分類モデルは、4 本の足、毛皮のコート、目立つ鼻を持つなど、猫のさまざまな特徴を識別できるため、犬の分類モデルは、元のモデルから受け継いだ特徴を識別するためのトレーニングをすべてスキップできます。これらをすべて引き継いだ上で、 ニューラルネットワーク 次に、猫の最も具体的な特徴を識別するために使用されたトレーニング済みモデルの最後の層を破棄し、それらを犬固有のデータセットに置き換えます。
学習の転移にはどのような AI モデルを使用できますか?
転移学習を使用するには、事前トレーニングされたモデルが必要です。事前トレーニングされたモデルは、特定のトピックやアイデアに関する一般的な知識を得る目的でトレーニングされた AI モデルとして知られています。これらのタイプの事前トレーニング済みモデルは、ユーザーがさまざまな用途に合わせて微調整し、より多くのモデルを作成できるように特別に設計されています。最も人気のある事前トレーニング済みモデルの一部は、BERT や GPT などの NLP 用と、VGG19 や Inceptionv3 などのコンピューター ビジョン用です。
一般的ではありますが、これらの簡単に適応できるモデルは、学習を伝えるために使用できる唯一のモデルではありません。一般に、オブジェクトまたは言語認識のより具体的なタスクでトレーニングされたモデルを使用することもできます。トレーニングしようとしているモデルに適用できるニューラル ネットワークがモデルに開発されている限り、任意のモデルを使用して学習を転移できます。
公開されている事前トレーニング済みモデルは、TensorFlow Hub、Hugging Face、OpenAI Model Marketplace などの場所から入手できます。確認する Microsoft Lobe を使用して機械学習モデルを作成する方法.
人工知能で転移学習を使用する利点
転移学習には、AI モデルを最初からトレーニングする場合に比べて多くの利点があります。
- トレーニング時間を短縮する: モデルをゼロからトレーニングする場合、トレーニング プロセスの大部分が一般的な基礎知識に費やされます。転移学習を通じて、モデルはこのすべての背景知識を自動的に継承するため、トレーニング時間が大幅に短縮されます。
- リソース要件の低減: 基本的な知識はすべてすでに整っているため、後はアプリケーションの詳細に基づいてモデルのトレーニングを続けるだけです。多くの場合、これには、より少ない計算能力で処理できる比較的小さなデータ セットのみが必要です。
- パフォーマンスの向上: モデルをゼロから構築するのに何百万ドルも費やさない限り、巨大テクノロジー企業の大規模言語モデル (LLM) と同じくらい優れた信頼性の高いモデルを期待することはできません。転移学習を使用すると、GPT などの事前トレーニングされた LLM の強力な機能を活用して、モデルのパフォーマンスを向上させることができます。
AI モデルを最初からトレーニングすることは可能ですが、それにはより多くのリソースが必要です。
学習の転移はどのように機能しますか?
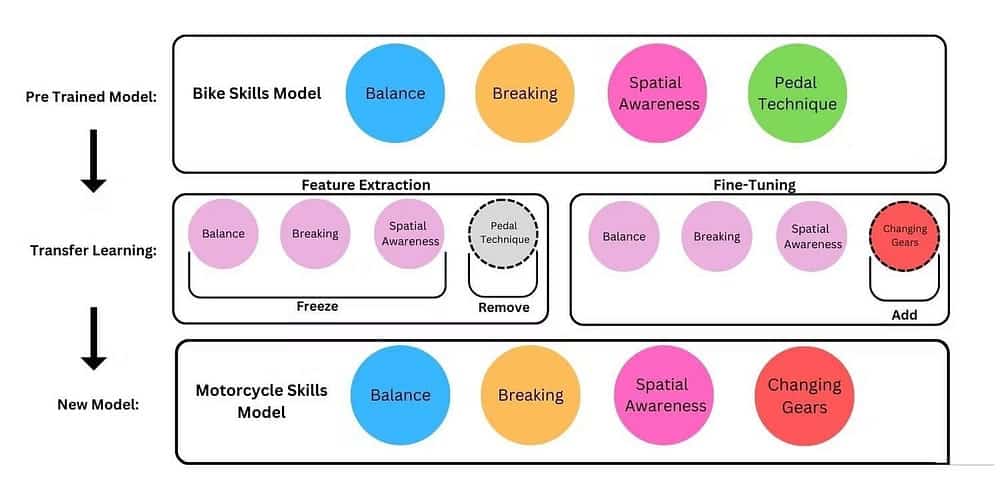
基本的に、学習の転移には 3 つの段階があります。
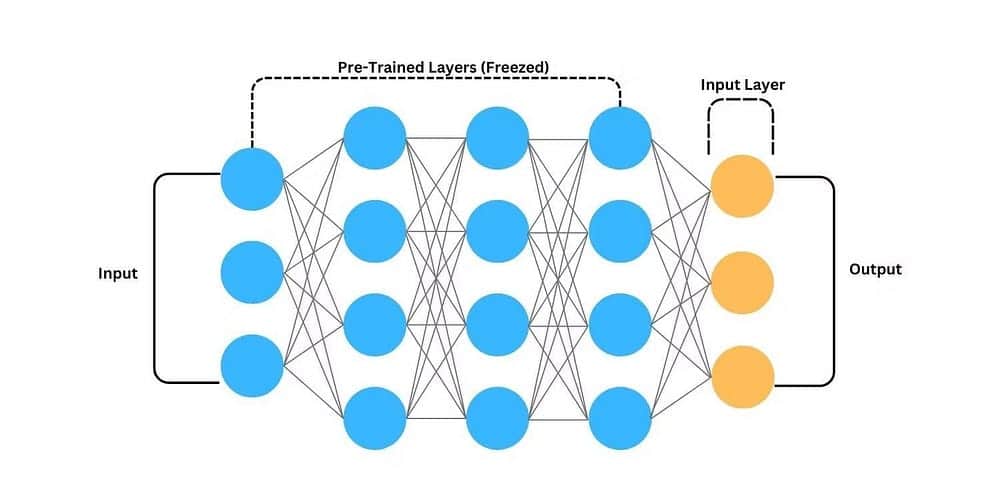
- 事前トレーニングされたモデルを選択する: 事前トレーニングされたモデルは、ImageNet や大規模なテキスト コーパスなどの関心のあるソースからの大規模なデータセットを使用して初期トレーニングを受けます。この初期トレーニング フェーズにより、モデルはデータ セットに存在する共通の特徴とパターンの知識を得ることができます。転移学習によって節約される時間とリソースの量は、事前トレーニングされたモデルと構築しようとしているモデルの間の類似点によって異なります。
- 特徴抽出: 微調整するために事前トレーニングされたモデルが選択されると、事前トレーニングされたモデル (入力に最も近い) の初期層は残されます。これは、微調整中に重みが一定に保たれることを意味します。これらのレイヤーをフリーズすると、事前トレーニング段階で学習した一般知識が保存され、ターゲット モデルのタスク データセットによって大きな影響を受けることがなくなります。特定のアプリケーション向けに完全にトレーニングされたモデルの場合、モデルの最終層は削除されるか、ターゲット モデルが他の特定のアプリケーションでトレーニングされるまで学習されません。
- 微調整: 事前トレーニングされたモデルをフリーズして上位層を削除した後、新しいデータセットが学習アルゴリズムに供給され、それが新しいモデルとそのアプリケーション プロパティのトレーニングに使用されます。
3 つの段階だけではありませんが、この図は、微調整を加えて転移学習 AI プロセスがどのように機能するかを大まかに詳しく示しています。
人工知能における転移学習の限界
転移学習は効率的で信頼性の高いモデルをトレーニングする上で貴重な概念ですが、転移学習を使用してモデルをトレーニングする場合には注意しなければならない制限がいくつかあります。
- タスクの不一致転移学習用の基本モデルを選択するときは、新しいモデルが解決する問題にできるだけ密接に関連している必要があります。猫を分類するモデルを使用して犬を分類するモデルを作成する方が、車の分類モデルを使用して植物のモデルを作成するよりも良い結果が得られる可能性があります。基礎となるモデルが構築しようとしているモデルとの関連性が高ければ高いほど、学習移転プロセス中により多くの時間とリソースを節約できます。
- データセットの偏り: 事前トレーニングされたモデルは大規模なデータセットでトレーニングされることがよくありますが、トレーニング中に特定のバイアスが生じた可能性が依然としてあります。偏りすぎる基本モデルを使用すると、モデルがその偏りを継承し、モデルの精度と信頼性が低下する可能性があります。残念ながら、ディープ ラーニングのブラック ボックスの性質により、これらのバイアスの原因を特定することは困難です。
- 付加装置: 転移学習の主な利点の 1 つは、比較的小さなデータセットを使用してモデルをさらにトレーニングできることです。ただし、小さすぎるデータセットでモデルをトレーニングすると過剰適合が発生する可能性があり、新しいデータを入力したときにモデルの信頼性が大幅に低下します。
したがって、転移学習は AI にとって有用な学習手法ではありますが、限界があり、特効薬ではありません。確認する 生成AIのセキュリティ問題が深刻化している理由.
転移学習を使用する必要がありますか?
事前トレーニングされたモデルが利用可能になって以来、より特殊なモデルを作成するために転移学習が長い間使用されてきました。モデルが解決する問題に関連する事前トレーニング済みモデルがすでに存在する場合、転移学習を使用しない本当の理由はありません。
シンプルな機械学習モデルを最初からトレーニングすることは可能ですが、深層学習モデルでトレーニングするには多くのデータ、時間、スキルが必要になります。これは、同じような既存のモデルを再利用できても意味がありません。あなたはトレーニングする予定です。したがって、モデルのトレーニングに費やす時間と費用を節約したい場合は、転移学習を通じて独自のモデルをトレーニングしてみてください。今すぐ閲覧できます 最適な AI アプリケーションを発見または検索するための AI ツールのオンライン ディレクトリ.