Excelの基本的な関数は単純な計算には適していますが、複雑なデータ分析を行うとなるとすぐに複雑になってしまいます。ネストされた数式は読みにくく、補助列が多用されてスプレッドシートが乱雑になり、データの変更によって数式が壊れてしまうといった問題も生じます。そこでExcelの行列数式が役立ちます。

配列数式を使用すると、1 つの数式でデータ範囲全体にわたって計算を実行できます。 したがって、 超高速検索を実行行や列ごとに個別の数式を記述する代わりに、1 つの強力な式を使用して、計算、フィルター、並べ替えを行うことができます。 これは Excel では目新しいことではありませんが、これらの関数によって作業が簡素化され、効率化されるにもかかわらず、従来のやり方に固執する人もいます。
クイックリンク
5. XLOKUP
常に VLOOKUP より優れています。
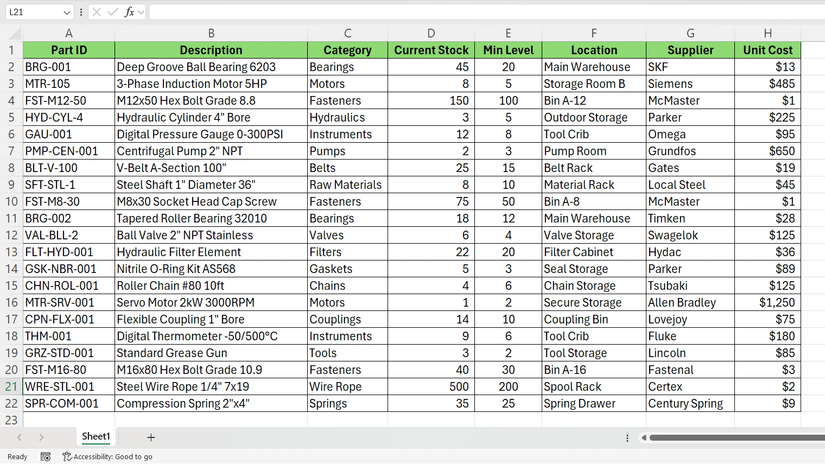
XLOOKUPは、最初から存在すべきだった検索関数です。列数を数えて右方向のみを検索するVLOOKUPとは異なり、XLOOKUPは任意の方向に検索でき、実際の列参照を使用します。構文は以下のとおりです。
= XLOOKUP(lookup_value、lookup_array、return_array、[if_not_found]、[match_mode]、[search_mode])
各パラメータの意味は次のとおりです。
- 参照値: 探している特定の値。部品番号、製品コード、またはデータセット内の任意の識別子がこれに該当します。
- lookup_array: Excelで検索する範囲 参照値 あなたのものです。これは通常、検索条件を含む単一の列または行です。
- 戻り配列: 取得したい値を含む範囲。単一の列、複数の列、あるいはテーブルセクション全体を指定できます。
- if_not_found(オプション): 一致するものが見つからない場合に表示されるカスタムテキストまたは値。煩わしい#N/Aエラーを排除し、「見つかりません」または「部品番号を確認してください」と表示できるようになります。
- match_mode(オプション): 一致の種類を制御します。完全一致(デフォルト)の場合は 0、次の完全一致またはより小さい一致の場合は -1、次の完全一致またはより大きい一致の場合は 1、ワイルドカード一致の場合は 2 を使用します。
- search_mode(オプション): 検索方向を指定します。最初から最後への検索(デフォルト)の場合は 1、最後から最初への検索の場合は -1、ソートされたデータに対するバイナリ検索の場合は 2 を使用します。
機械在庫のスプレッドシートを例に挙げてみましょう。次の数式は、部品IDの範囲内で部品番号「BRG-002」を検索し、対応するデータを返します。部品が見つからない場合は、エラーではなく「部品が見つかりません」と表示されます。
=XLOOKUP("BRG-002", A:A, A:H, "部品が見つかりません")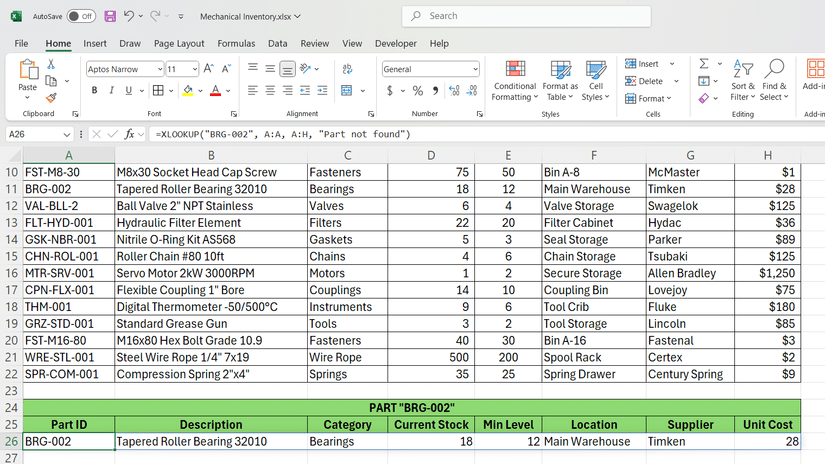
XLOOKUPは、VLOOKUPのような面倒な列計算をすることなく、異なる列からデータを抽出できるため、最も重要なものの一つとなっています。 データを素早く見つけるためのExcel関数.
4. SUMPRODUCT
条件計算用発電所
SUMPRODUCTは数値を加算するだけでなく、行列を乗算して結果を合計します。そのため、複数の補助列を必要とする複雑な条件付き計算に便利です。



その式は次のようになります。
=SUMPRODUCT(配列1, [配列2], [配列3], ...)
ここ、 array1 これは乗算する最初の値の範囲です。通常は、数量やコストなどの主要なデータ列です。 array2 これは乗算のオプションの 2 番目の範囲であり、多くの場合、比較演算子を使用した基準または条件付きロジックが含まれます。
論理演算子は、配列内で使用する際に特に役立ちます。例えば、「(supplier="Siemens")」のような条件を入力すると、ExcelはTRUE/FALSEの結果を1/0に変換し、計算を可能にします。
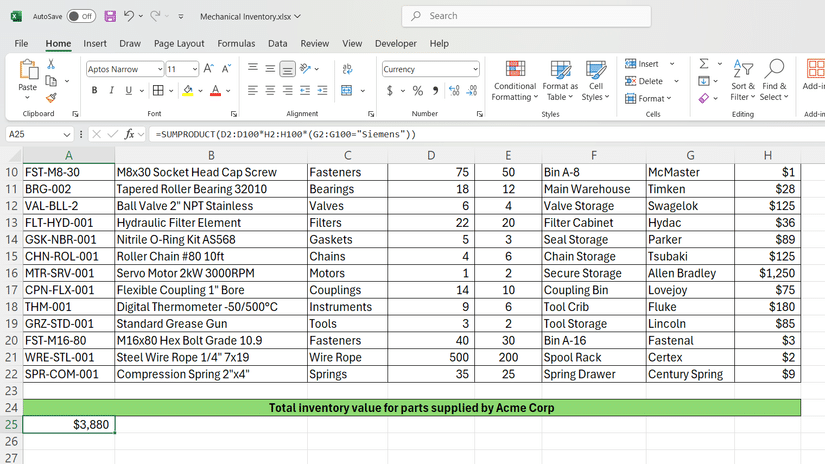
例えば、次の数式は、シーメンスのみが供給する部品の合計在庫額を計算します。この数式は、サプライヤーが条件を満たす行のみを対象に、数量と単価を乗算します。
=SUMPRODUCT(D2:D100*H2:H100*(G2:G100="Siemens"))
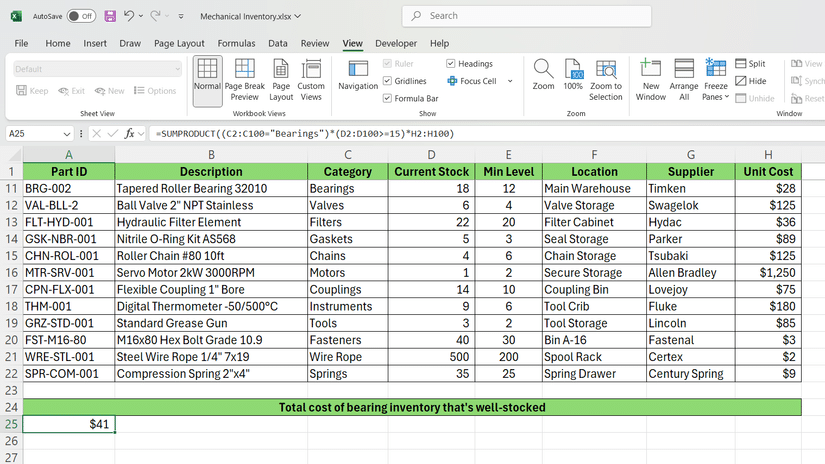
同様に、次の式は、十分な供給があるベアリングの在庫の合計コストを計算します。
=SUMPRODUCT((C2:C100="Bearings")*(D2:D100>=15)*H2:H100)
15 つの条件が同時に適用されます。カテゴリは「ベアリング」で、在庫レベルは XNUMX ユニット以上である必要があります。これにより、十分な在庫範囲を持つベアリング カテゴリを識別することができます。
複数の条件を持つ従来の SUM 関数とは異なり、SUMPRODUCT は、複数の条件を 1 つの読みやすい数式で処理するため、複雑なネスト構造を必要としません。 ExcelのSUM関数 SUMIF や SUMIFS と同様に、単純な条件付き合計には優れていますが、合計する前に値を乗算したり、より複雑な論理演算を処理する必要がある場合は、SUMPRODUCT 関数が優れています。
3. フィルター
動的なデータ抽出を簡単に
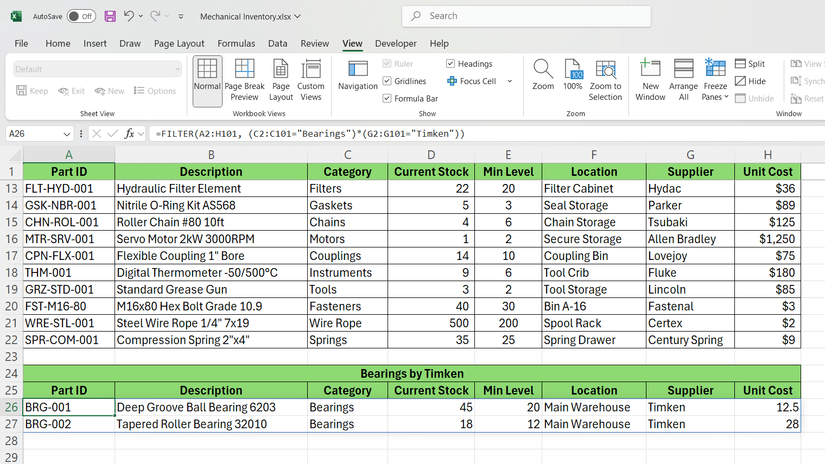
FILTERは、指定した条件に基づいてデータセットから行を抽出します。手動フィルタリングとは異なり、この関数は動的な結果を生成します。結果はソースデータが変更されると自動的に更新されます。FILTERの構文は次のとおりです。
=FILTER(配列、インクルード、[if_empty])
各入力が制御する内容は次のとおりです。
- 配列(範囲): フィルタリングするデータの全範囲。これには、条件列だけでなく、結果に表示したいすべての列が含まれます。
- 含む: 返される行を指定する論理条件 - 比較演算子を使用して、各行の TRUE/FALSE 配列を作成します。
- if_empty(オプション): 条件に一致する行がない場合、カスタムメッセージを表示します。#CALC! エラーを防ぎ、「一致する結果は見つかりませんでした」などのわかりやすいテキストを表示します。
この関数は、範囲内の各行に対して条件を評価します。条件がTRUEを返すと、その行全体がフィルタリングされた結果に表示されます。以下は、機械在庫のスプレッドシートの例です。
=FILTER(A2:H101, (C2:C101="Bearings")*(G2:G101="Timken"))
この数式は、リソースが「Timken」でカテゴリが「Bearings」であるすべての行を抽出します。アスタリスク(*)は、論理配列を乗算して AND 条件を作成します。
ソース範囲に新しいデータを追加すると、 ExcelのFILTER関数の使い方 フィルタリングされた結果が自動的に更新されるため、手動で並べ替えたり、一時テーブルを作成したりするよりも合理的です。これは、ライブダッシュボードやレポートの作成に役立ちます。
2. ユニーク
重複のない一意の値を抽出する
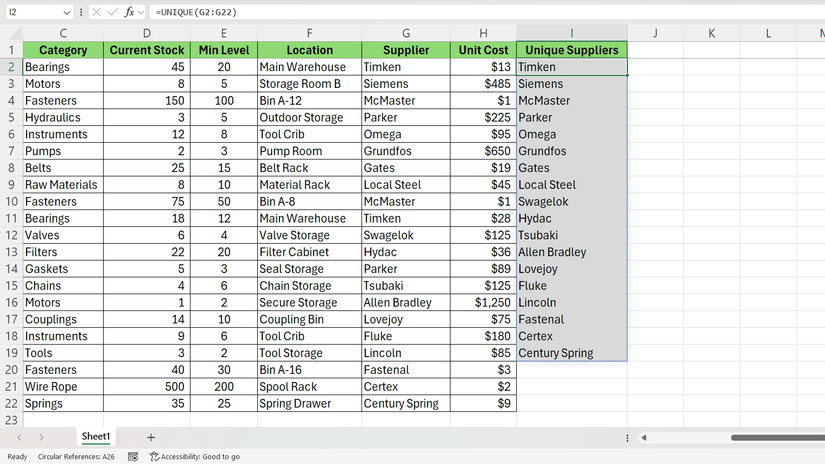
UNIQUE関数は、データ範囲から一意の値を抽出し、重複を自動的に回避します。この関数は、ドロップダウンリストの作成、データカテゴリの分析、サマリーレポートの作成などに便利です。式は次のとおりです。
=UNIQUE(配列, [by_col], [exactly_once])
各入力の動作は次のとおりです。
- 配列(範囲): 重複を削除するデータを含む範囲。1 つの列、複数の列、または表のセクション全体を指定できます。
- by_col (オプション): FALSE は行を比較して一意性を判断します(デフォルト)。一方、TRUE は列を比較します。ただし、ほとんどのシナリオではデフォルトの行比較が使用されます。
- exact_once (オプション): FALSE は、複数回出現する値も含め、すべての一意の値を返し (デフォルト)、TRUE は、データセット内に 1 回だけ出現する値のみを返します。
UNIQUE関数は配列内の各行または値を評価し、各一意の要素の最初の出現のみを返します。順序は元のデータシーケンスと一致します。例を以下に示します。
=ユニーク(G2:G22)
この数式は、仕入先列Gからすべての一意の仕入先名を抽出し、クリーンな重複リストを作成します。私はこれを、仕入先ドロップダウンリストやサマリーレポートの作成に使用しています。
次に示すように、テーブル全体で使用することもできます。
=ユニーク(A2:F100)
すべての列(A~F)にわたって一意の組み合わせを返し、異なる在庫レコードを表示します。各列で2つの部品が同じ値を持つ場合、結果にはそのうちの1つだけが表示されます。
大規模なデータセットを扱う場合、UNIQUE を使用すると、手動で重複データを削除するという面倒な作業が不要になります。新しいデータが到着するたびに結果が動的に更新され、また UNIQUE はスピルオーバー行列を作成するため、すべての一意の値に合わせて自動的にスケーリングされるため、テーブルのサイズを変更する手間が省けます。私はこれを、参照リストを整理し、信頼性の高いデータ検証範囲を構築するために使用しています。
1. SORTとSORTBY
元のデータを損なうことなくデータを整理
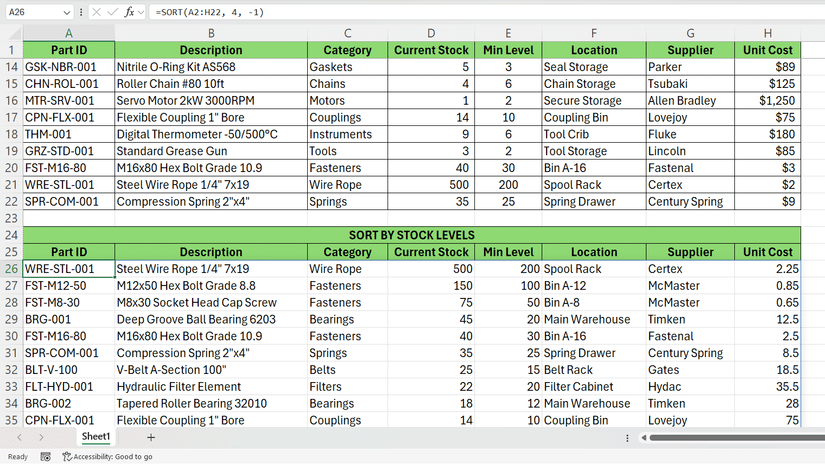
SORT関数とSORTBY関数は、ソースデータを保持したままデータを動的に整理します。SORT関数は列の位置による基本的な並べ替えを処理し、SORTBY関数は異なる列の値に基づいて並べ替えることで、より柔軟な複雑な並べ替えが可能になります。
SORT は次の構造を使用します。
=SORT(配列、[並べ替えインデックス]、[並べ替え順]、[並べ替え順])
各パラメータが制御する内容は次のとおりです。
- アレイ: 並べ替えるデータの範囲には、並べ替えられた結果に表示されるすべての列が含まれます。
- sort_index (オプション): 配列内で並べ替える列番号。最初の列には1、2番目の列には1、というように指定します(デフォルトはXNUMX)。
- sort_order (オプション): 昇順の場合は 1 (デフォルト)、降順の場合は -1 を使用します。
- by_col (オプション): 行で並べ替える場合は FALSE (デフォルト)、列で並べ替える場合は TRUE です。ほとんどのシナリオでは行の並べ替えが使用されます。
SORTBY 関数は次の形式になります。
=SORTBY(配列, by_array1, [sort_order1], [by_array2], [sort_order2], ...)
取引内容は以下のとおりです。
- アレイ: 並べ替えるデータの範囲。SORT 関数と同様に、結果に必要なすべての列が含まれます。
- by_array1: 並べ替え順序を決定する値を含む範囲は、メイン配列の範囲外であっても、任意の列にすることができます。
- sort_order1(オプション): 昇順の場合は 1 (デフォルト)、降順の場合は -1 です。
- by_array2、sort_order2(オプション): 複数レベルの並べ替えのための追加の並べ替え基準。
機械在庫スプレッドシートの例を見ると、これらの関数は実際の並べ替えのシナリオを処理します。
=SORT(A2:H22, 4, -1)
この式は、在庫全体を在庫レベルの高い順に並べ替え、在庫数が最も多い商品を先頭に表示します。この式は、行間の関係性をすべて維持しながら、列4(在庫レベル)で並べ替えます。
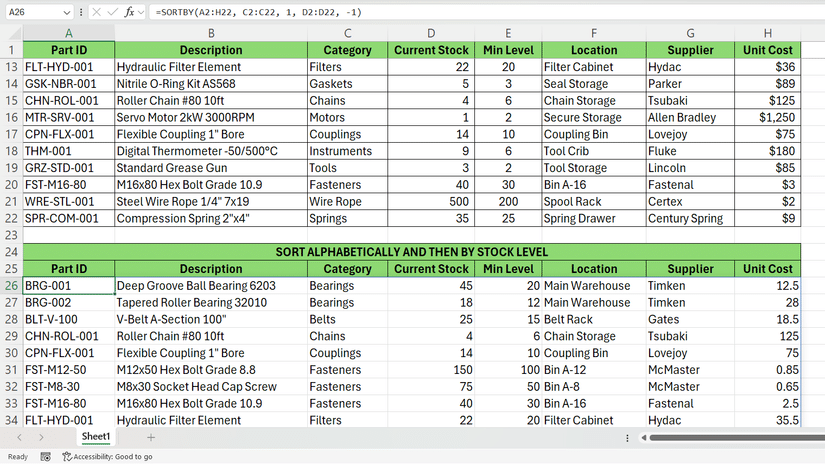
SORTBY関数を使用しています。 SORT関数の代わりに、並べ替えの条件や複数の並べ替えレベルをより細かく制御できます。例えば、次の数式は、まずカテゴリごとにアルファベット順に並べ替え、次に各カテゴリ内で在庫レベルの高い順に並べ替えます。
=SORTBY(A2:H22, C2:C22, 1, D2:D22, -1)
整理されたスプレッドシート、よりスマートな結果
配列数式は、スプレッドシートのメンテナンスを困難にする補助列やネストされた関数の煩雑さを排除します。単一の数式で複数の操作を処理できるため、ワークブックはより整理され、プロフェッショナルなものになります。
注目すべき利点の一つは、動的関数です。これは、ソースデータが変更されると結果が自動的に更新される機能です。これにより、手動での更新や数式文字列の破損がなくなり、スプレッドシートの継続的な分析における信頼性が向上します。
Excelの配列関数ライブラリは、これらの基本的なツールを超えて拡張され続けています。複数のソースからデータを結合する必要がある場合は、VSTACK関数とHSTACK関数を使って範囲を結合します。これらの関数を組み合わせることで、従来の数式では不可能だった強力なデータ処理ワークフローを実現できます。