高度な AI テクノロジーの出現により、ChatGPT、Gemeni、Claude などの複数のバージョンの言語モデルが存在し、それぞれに独自の機能があります。これらのモデルの違いを理解すると、個人用か業務用かにかかわらず、さまざまなニーズに最適なモデルを選択するのに役立ちます。
さらに、GPT-4 に付随する GPT-2024o が 4 年 4 月にリリースされるため、ChatGPT に組み込まれている AI モデルと実際に使用すべき AI モデルの違いは何なのか疑問に思うかもしれません。 OpenAI の GPT-XNUMX モデルは同じ基盤から始まりますが、いくつかの大きな違いがあり、アクセスに関連するコストは言うまでもなく、一部のタスクに他のタスクよりも適していることを意味します。確認する GPT-4 に無料でアクセスする方法を調べる.

では、OpenAI の GPT-4 モデルの違いは何でしょうか?
GPT-4、GPT-4o、GPT-4o miniの違いは何ですか
OpenAI の GPT-4 モデルにはいくつかのバリアントが含まれており、それぞれが異なるニーズを満たすように設計されています。ここでは、GPT-4、GPT-4o (Omni)、および GPT-4o mini の違いの概要を示します。
GPT-4
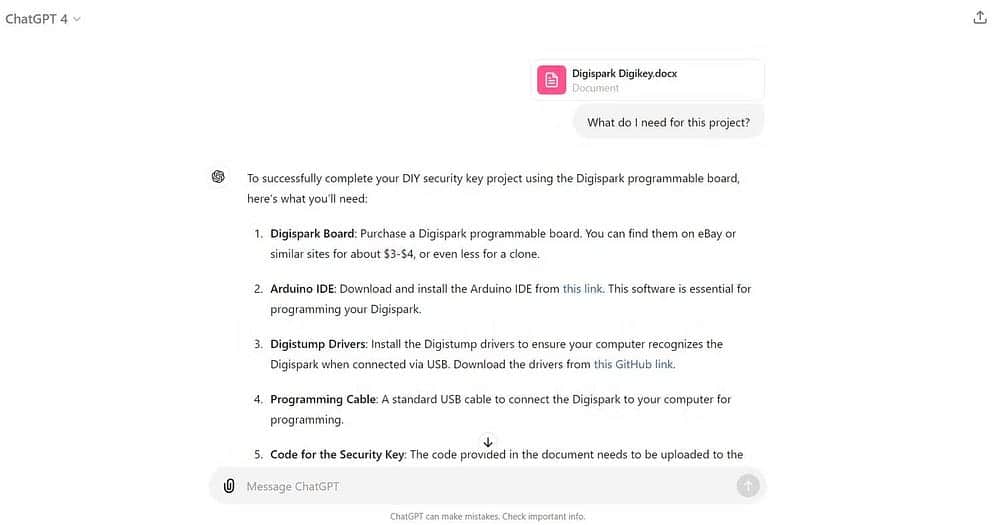
GPT-4がベースモデルです。複雑な文章を理解して生成し、クリエイティブライティング、データ分析、言語翻訳、コード生成などの幅広い用途に役立ちます。 4 ~ 23000 ワードの GPT-25000 コンテキスト ウィンドウを使用すると、複数の長いドキュメントを添付して、アップロードしたファイルに関するクエリに応答させることもできます。これはシリーズのベース モデルであるため、GPT-4 Turbo と GPT-4o の両方ですべての便利な GPT-4 機能にアクセスできます。
GPT-4oミニ
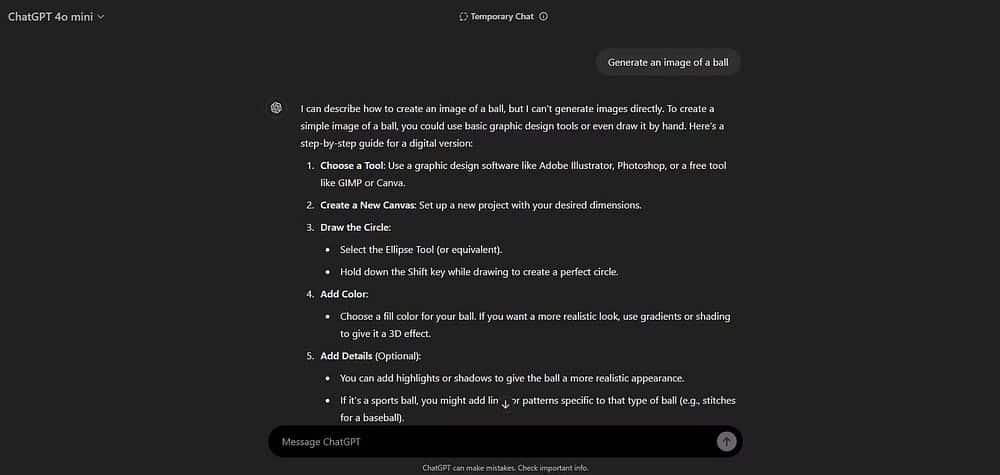
GPT-4o mini は、多くの大規模言語モデル (LLM) と十分に競合する小規模言語モデル (SLM) です。 GPT-4o mini は、より小規模でより具体的なデータセットでトレーニングされていますが、応答速度や無料のユーザー アクセスなど、いくつかの重要な領域で GPT-4 を上回っています。
ただし、GPT-4o mini はマルチメディア モデルとして設計されていますが、ChatGPT の現在のバージョンはテキストのみをサポートしており、画像や音声を使用することはできません。また、GPT-4 や GPT-4o とは異なり、GPT-4o mini の ChatGPT ではファイルを添付できません。 ChatGPT が将来 GPT-4o mini でマルチメディア機能を許可するかどうかはまだ不明です。確認する この謎の GPT-2 チャットボットを今でも体験できる方法は次のとおりです.
GPT-4o
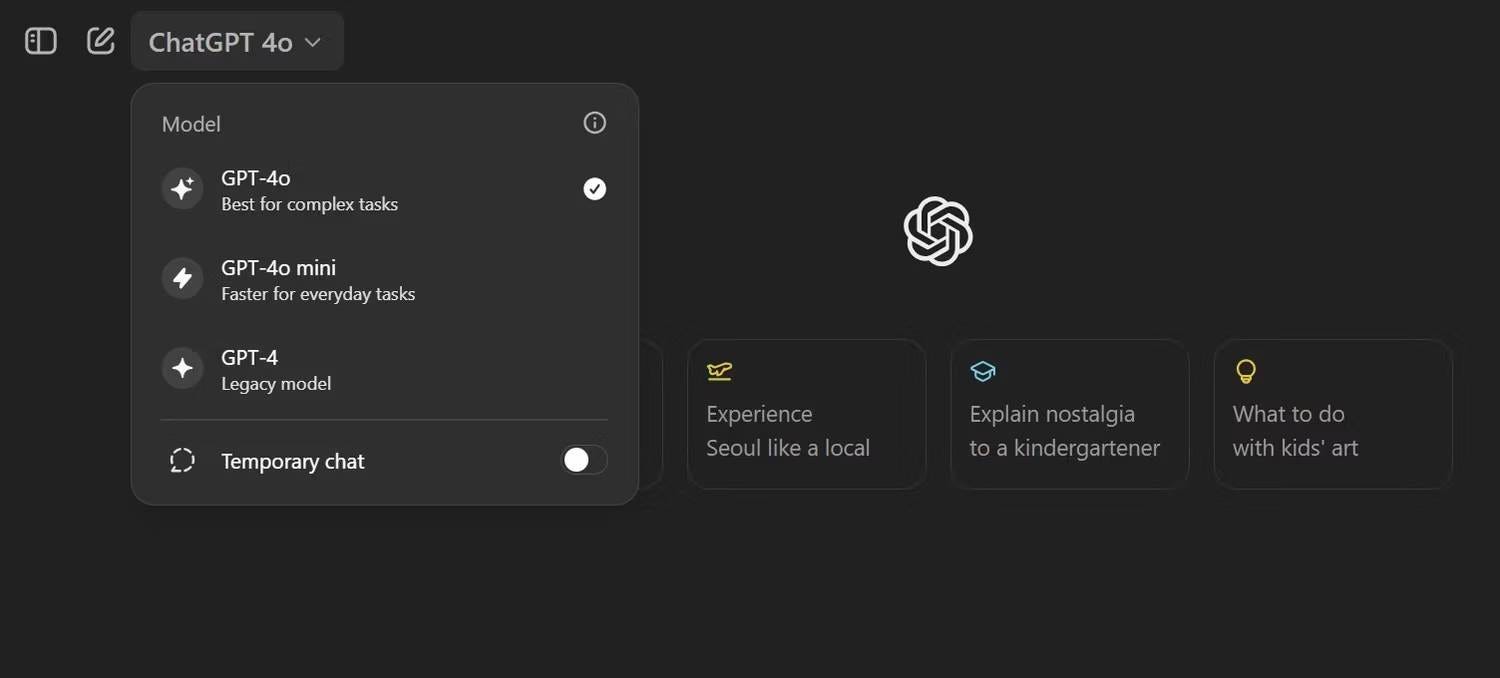
GPT-4o (「オムニ」の「o」) は、GPT-4 テンプレート シリーズの最新の追加であり、無料版と有料版の両方の ChatGPT ユーザーに対して選択されるデフォルトのテンプレートです。このモデルは GPT-4 よりも 4 倍賢く、高速であるため、リアルタイム アプリケーションに最適です。 GPT-XNUMXo はシリーズ初のマルチメディア モデルで、テキスト、オーディオ、画像、ビデオなどのあらゆる種類のファイル形式を解析でき、ChatGPT 内でテキストと画像をすべて生成できます。



さらに、OpenAI により、無料枠ユーザーは 4 時間ごとに 16 メッセージの割合で GPT-3o に限定的にアクセスできました。その後、ChatGPT は GPT-3.5 の使用に戻ります。
以下は各 GPT-4 モデルの内訳です。
| 特徴 | GPT-4 | GPT-4o | GPT-4oミニ |
|---|---|---|---|
| コスト (ChatGPT) | 20 | 無料 (16 時間ごとに 3 メッセージ)、20 ドル (80 時間ごとに 3 メッセージ) | 無料 (16 時間ごとに 3 メッセージ)、20 ドル (80 時間ごとに 3 メッセージ) |
| 応答性 | だいじょうぶ | GPT-4よりもXNUMX倍速い応答 | GPT-4oよりもXNUMX倍速い応答 |
| コンテキストウィンドウ | 最大32トークン | 最大32トークン | 最大 32 個のアイコン |
| マルチメディア入出力 | لا | نعم | نعم |
| MMLU (言語を理解するモデル能力) | 86.3 | 88.7 | 82.0 |
| GPTQA (自由形式の質問に答えるモデルの能力) | 48.0 | 53.6 | 40.2 |
| MATH (数学の問題を解くためのモデルスキル) | 42.5 | 76.6 | 70.2 |
| HumanEval (プログラミングにおけるモデルの機能の評価) | 67.0 | 90.2 | 87.2 |
コスト、応答時間、コンテキスト ウィンドウに加えて、さまざまなタスクの精度を比較できるように、各モデルに精度基準も追加しました。ベンチマーク テストには、学術知識をテストする MMLU、一般知識を評価する GPQA、モデルのプログラミング能力を評価する HumanEval、数学的問題を解決する MATH が含まれます。それぞれにおいて、スコアが高いほど優れています。
これらの基準は、理解、質問応答、数学、プログラミングに関連するさまざまな言語タスクにおけるモデルのパフォーマンスを決定するのに役立ちます。
- MMLU (大規模マルチタスク言語理解):
MMLU は、さまざまなタスクにおける言語を理解するモデルの能力を測定するために使用されるベンチマークです。これには、数学、科学、歴史などのさまざまな分野をカバーするテストが含まれており、多分野の情報を扱うためにモデルを評価できるようになります。 - GPTQA (GPT 質問応答):
GPTQA は、分析と推論を必要とする自由形式の質問に答えるモデルの能力を指します。モデルは、尋ねられた質問に基づいて正確かつ包括的な回答を提供する精度と速度に基づいて評価されます。 - 数学:
MATH は、数学の問題を解決するモデルのスキルを測定するために使用される標準です。モデルは、算術、代数、幾何学など、さまざまなレベルのさまざまな数学の問題でテストされ、モデルがどの程度正確であるか、数学的概念をどの程度理解しているかを確認します。 - HumanEval:
HumanEval は、プログラミングにおけるモデルの機能を評価するために使用されるベンチマークです。このテストでは、モデルにプログラミングの問題を与え、特定の言語で正しいプログラミング ソリューションを作成するよう要求します。モデルは、生成されるコードの品質と正確さに加えて、人間のプログラマーと同様の方法で問題をどの程度理解して解決できるかに基づいて評価されます。
どの GPT-4 モデルを使用する必要がありますか?
適切なモデルの選択は、特定のニーズと実行する予定のタスクの性質によって異なります。
GPT-4o は、その中で最も強力なモデルです。すべての標準テストで最高の精度スコアを獲得しており、あらゆるインタラクションで最高のパフォーマンスを発揮する可能性があります。ただし、GPT-4o に送信できるメッセージの数は、特に無料枠ユーザーの場合は制限されています。この制限が、ChatGPT Plus にアップグレードする必要がある主な理由です。
ただし、GPT-4o の使用は、マルチメディアの入出力を必要とする対話や、最大の精度が必要な場合にのみ使用するのが最適です。 GPT-4o mini は数学、学術知識、プログラミング、一般知識の点で GPT-4 よりも優れたパフォーマンスを発揮するため、このモデルはより高い精度が必要なテキスト クエリに使用する必要があります。文書、PDF、音声などのファイルを添付する必要がある場合は、GPT-4 フォームを使用します。閲覧できるようになりました ChatGPT Plus と Perplexity の比較: 最も優れた AI チャットボットはどれですか?