今日私たちが利用するAIツールのほとんどはクラウドコンピューティング上で動作するため、常時インターネット接続が必要です。デバイス上でAIツールをローカルに実行する選択肢もありますが、そのためには高性能で高価なハードウェアが必要だという認識が一般的です。
私もそう思っていましたが、比較的古いマシン(1070年近く前のGTX XNUMXグラフィックカード)でネイティブAIツールをいくつか試してみたところ、実際にそれが可能で効果的であることがわかりました。この実験により、それほどスペックが高くないデバイスでもAIを活用できる新たな可能性が開かれ、より幅広いユーザーがこの技術を利用できるようになりました。

クイックリンク
なぜローカル AI チャットボットを使用する必要があるのでしょうか?
ChatGPT、Gemini、Claudeなど、数え切れないほどのAI搭載オンラインチャットボットを使ってきました。どれも素晴らしい機能です。しかし、インターネットに接続できない状況でもAIチャットボットを使いたい時はどうすればいいのでしょうか?あるいは、非常にプライベートな内容や、仕事上などのために公開できない情報を扱いたい場合などはどうすればいいのでしょうか?
このような場合、すべての会話とデータをデバイス上に保存するローカルのオフライン大規模言語モデル(LLM)が必要になります。 ローカルAIチャットボット インターネット接続に依存せずに人工知能の力を活用します。
プライバシーは考慮される 大規模なローカル言語モデルを使用する主な理由の1つはしかし、検閲の回避、オフラインでの使用、コスト削減、カスタマイズなど、他の理由もあります。 ローカルAIチャットボット データを完全に制御し、機密情報を安全に保護します。
量子化大規模言語モデル (量子化 LLM) とは何ですか?
オンプレミスで大規模言語モデル(LLM)を利用したいと考える多くの人にとって、ハードウェアは最大の課題です。最も強力なAIモデルを実行するには、強力なハードウェアが必要です。使いやすさに加えて、ハードウェアの制約も、AI搭載チャットボットのほとんどがクラウドコンピューティングをベースとしている理由の一つです。
ハードウェアの制限は、大規模言語モデル(LLM)をネイティブで実行できないと考えた理由の一つです。現在、私のPCはAMD Ryzen 5800xプロセッサ(2020年発売)、32GBのDDR4 RAM、GTX 1070 GPU(2016年発売)と、かなり控えめな構成です。そのため、最高級のハードウェアではありませんが、最近はあまりゲームをしない(そしてするとしても、 古くてリソースをあまり消費しないインディーゲーム) と現代の GPU の高コストを考えると、私は今持っているものに満足しています。
しかし、最も強力な AI モデルは必要ないことが判明しました。 量子化大規模言語モデル(量子化LLM) これらは、使用するデータ、具体的には小数点付きの数値を簡素化することで、より小型かつ高速化された AI モデルです。
AIは通常、高精度の数値(32ビット小数など)で動作し、大量のメモリと処理能力を消費します。量子化は、モデルの動作に大きな変化を与えることなく、これらの数値を低精度の数値(8ビット整数など)に縮小します。これにより、モデルはより高速に動作し、使用するストレージ容量が少なくなり、スマートフォンや周辺機器などの小型デバイスでも動作できるようになります(ただし、精度が若干低下する場合があります)。



つまり、私の古いハードウェアでは、3.1 億パラメータの Llama 205 と同じくらい強力な大規模言語モデル (LLM) を実行するのは確かに困難ですが、代わりにより小さな 8B の量子モデルを実行できるということです。
そして、 OpenAIが発表 最初の完全に量子化されたオープン重み付け推論モデルについては、古いハードウェアでどれだけうまく動作するかを確認する時期が来たと思いました。
Nvidia GTX 1070 グラフィック カードと LM Studio を使用して大規模言語モデル (LLM) をローカルで使用するにはどうすればよいでしょうか?
このセクションの冒頭で、私はローカル大規模言語モデル(LLM)の専門家でもなければ、このインテリジェントモデルを自分のマシンで実行するために使用したソフトウェアの専門家でもないことをお伝えしておきます。ここでは、GTX 1070グラフィックカード上でスマートチャットボットをローカルで実行するために行ったことと、このソリューションの効率性の評価について簡単に説明します。クラウドサービスに頼ることなく、利用可能なコンピューティングパワーを活用して高度なAIモデルを実行する方法を示すことが目的です。
LM Studioをダウンロード
大規模言語モデル(LLM)をローカルで実行するには、専用のソフトウェアが必要です。具体的には、プログラム LMスタジオは、LLMモデルをデバイスにダウンロードしてローカルで実行できる無料ツールです。LM Studioのホームページにアクセスし、 [オペレーティング システム] 用のダウンロード (私は Windows 10 を使用しています。) LM Studio は、さまざまな大規模言語モデルを試して、展開前に個人のマシンでパフォーマンスを評価したい開発者や研究者にとって理想的なプラットフォームです。
これはWindowsの標準的なインストール手順です。セットアッププログラムを実行し、インストールを完了してからLM Studioを起動してください。 パワーユーザー この機能を使うと、探索したい便利なオプションがいくつか表示されます。このオプションを使用すると、プログラムの設定をより細かく制御でき、LLMモデルの使用体験をカスタマイズするための高度なオプションも利用できます。LM Studioを使えば、大規模言語モデルの世界を簡単かつ効率的に探索できます。
最初のローカルAIモデルをダウンロードする
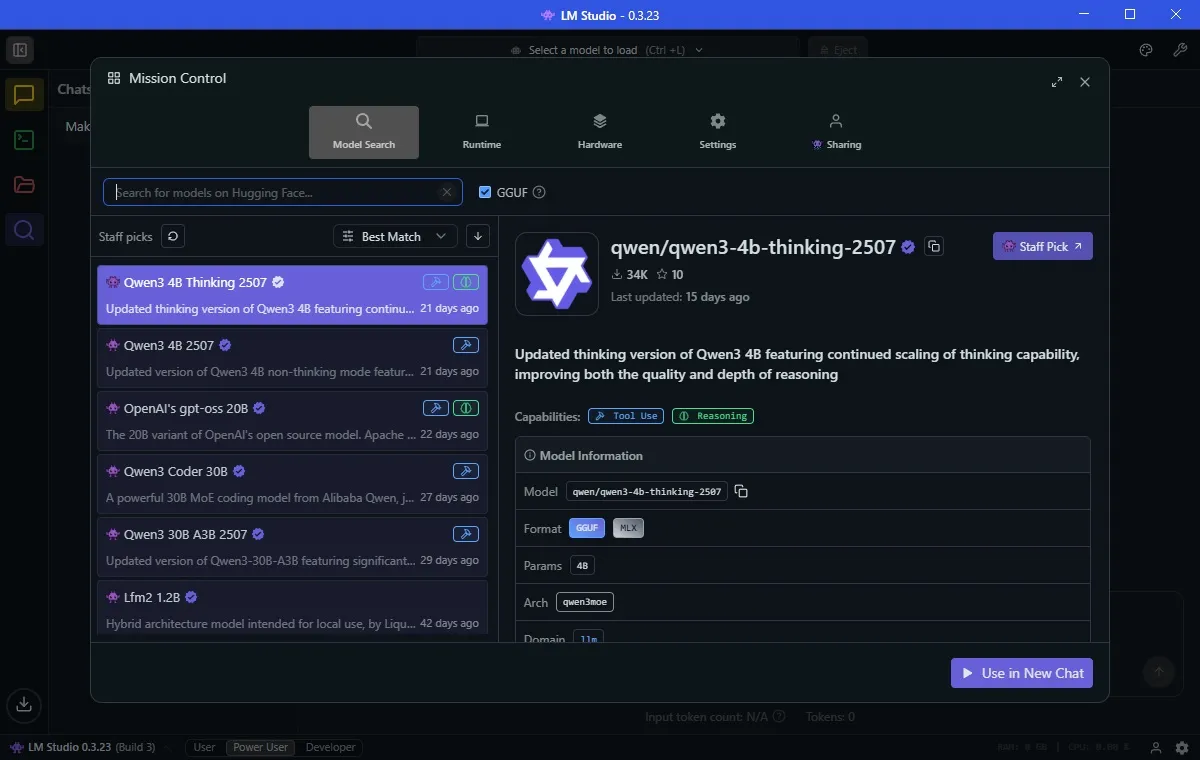
インストール後、最初の大規模言語モデル(LLM)をロードできます。タブを選択します。 探索する (虫眼鏡アイコン)。LM Studio は、お使いのデバイスに最適なネイティブ AI モデルを簡単に表示します。
私の場合、次のようなテンプレートをダウンロードすることを提案しています。 クウェン 3-4b-思考-2507モデル名はQwen(中国のテクノロジー大手アリババが開発した)は、このモデルの4番目のバージョンです。「2507b」という値は、このモデルが25億のパラメータを使用して応答することを意味し、「thinking」は、このモデルが応答する前に時間をかけて回答を検討することを意味します。最後に、XNUMXは、このモデルが最後に更新されたXNUMX月XNUMX日です。
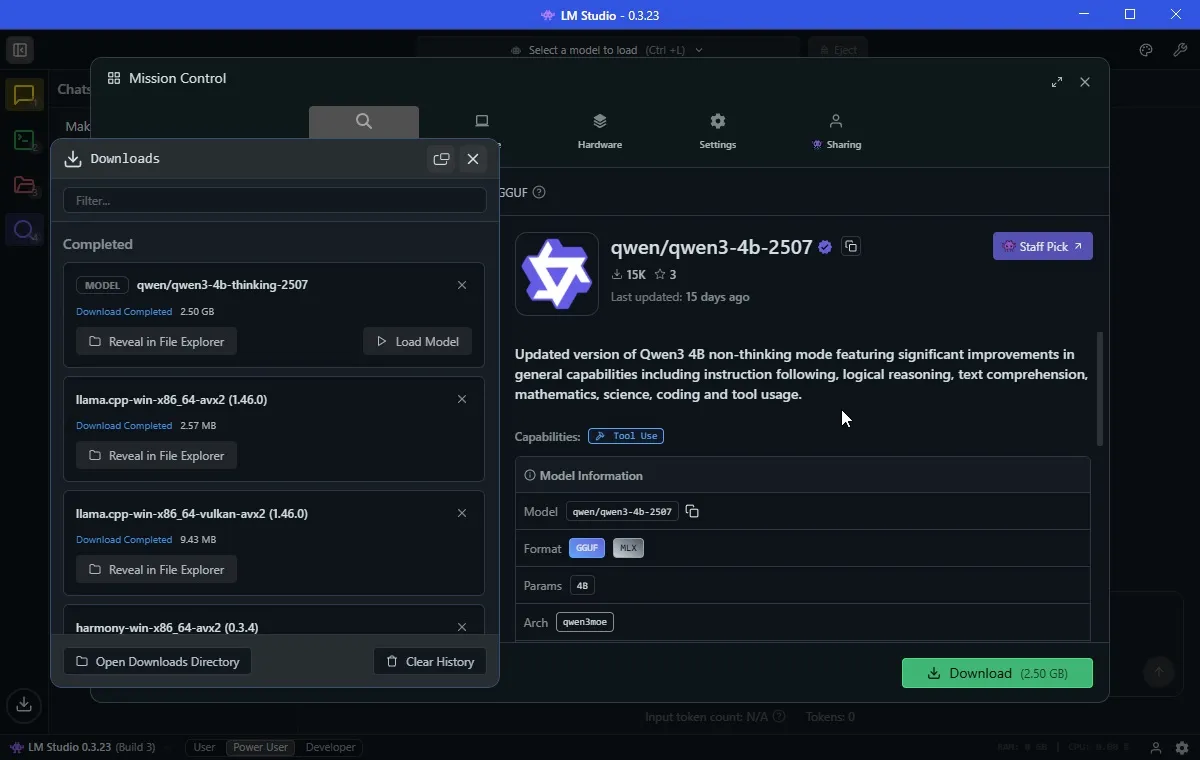
Qwen3-4b-thinking はわずか2.5GBなので、ダウンロードに時間はかからないでしょう。以前、OpenAI/gpt-oss-20b もダウンロードしましたが、こちらは12.11GBとサイズが大きいです。こちらも20億個のパラメータを備えているため、リソースコストは高くなりますが、より「優れた」答えが得られるはずです。
さて、 AIモデルの命名の複雑さLLM をダウンロードしたら、すぐに使い始めることができます。
AIモデルを実行する前に、タブに移動してください Hardware LM Studioがシステムを正しく認識していることを確認してください。下にスクロールして調整することもできます。 ガードレール ここに、私のコンピュータのファイアウォールを次のように設定しました バランスのとれたこれにより、1 つの AI モデルが過剰なリソースを消費してシステムが過負荷になるのを防ぎます。
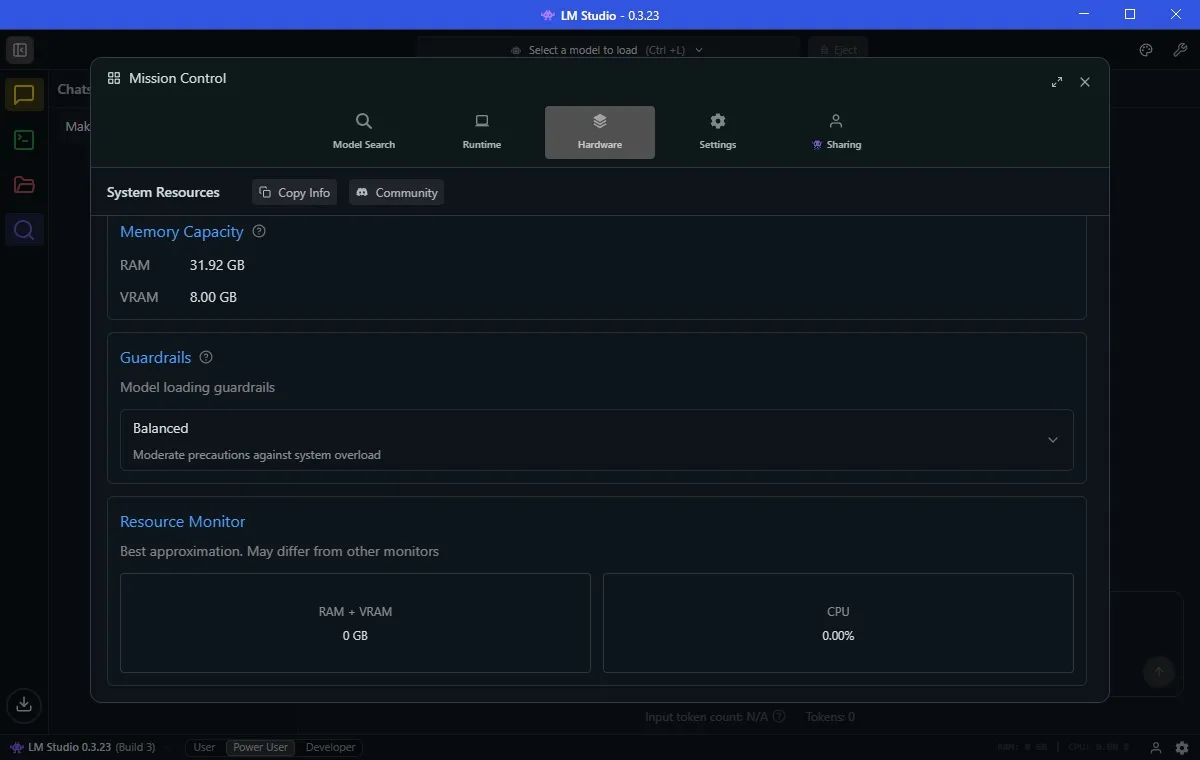
また、気づくでしょう リソースモニター ガードレールの下。これは、AIモデルがどれだけのシステム使用量を消費しているかを確認する簡単な方法です。私のようにハードウェアの性能がかなり限られている場合は、システムが予期せずクラッシュするのを避けるため、監視する価値があります。
AI モデルをアップロードして使い始めましょう。
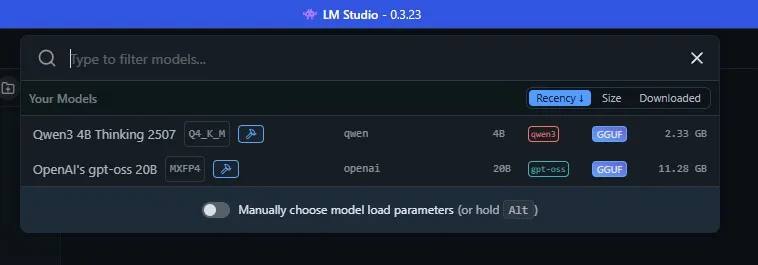
これで、AIチャットボットをデバイス上でローカルに使用できるようになりました。LM Studioでは、検索ツールとして機能する上部のバーを選択してください。AI名を選択すると、AIモデルがコンピュータのメモリに読み込まれ、コマンドや質問の入力を開始できます。このプロセスは、大規模言語モデル(LLM)の機能をデバイス上で直接有効にするために必要です。これにより、常時インターネット接続を必要とせずに、AIをインタラクティブかつ迅速に体験できるようになります。モデルのパフォーマンスはデバイスの仕様に依存するため、AIモデルを効率的に実行するための十分なリソースがあることを確認してください。
古いハードウェア上でローカルに AI モデルを実行する: 素晴らしいが、制限もある
AIモデルをローカルで実行すると、通常通りそのメリットを享受できますが、いくつかの重要な制限事項があることに留意する必要があります。これらのローカルモデルは有用ではありますが、ChatGPTで使用されているGPT-5のような最先端のモデルほど強力ではありません。さらに、思考と応答のプロセスにかかる時間が大幅に長くなり、応答の質が大きく変動する可能性があることに気付くでしょう。
例えば、Qwenとgpt-ossの両方で、古典的な大規模言語モデル(LLM)をテストしたところ、どちらも長い待ち時間の後ではあるものの、タスクを完了できました。これは、古いマシンでネイティブAIモデルを使用することは実用的な解決策になり得ることを示していますが、忍耐力と古いハードウェアの限界への理解が必要です。
アレン、ボブ、コリン、デイブ、エミリーが輪になって立っています。アレンはボブのすぐ左にいます。ボブはコリンのすぐ左にいます。コリンはデイブのすぐ左にいます。デイブはエミリーのすぐ左にいます。アレンのすぐ右にいるのは誰ですか?
Qwenは正しい結論に到達するまでに5分11秒かかりました。GPT-5は約45秒しかかかりませんでした。しかし、誰が最も優れた結果を残しましたか?それは、20秒という記録タイムを記録したgpt-oss-31bです。
5回のテストだけでは不十分なので、AIの推論能力をテストするために設計された別のパズルで試してみました。以前のテストでは、OpenAIの最新モデルであるGPT-XNUMXがこのテストに失敗したため、オフライン版のQwenとgpt-ossがどのように対応するかを見てみたいと思いました。
論理的問題を解決する人工知能モデルのパフォーマンスの分析
論理的な問題を解決する能力は、AIモデルにとって真の課題です。上記の、人々の集団間の空間関係を特定する例は、これらのモデルのパフォーマンスがいかに変動しやすいかを示しています。
空間関係と人工知能の課題
空間関係の処理は人工知能の基本的な部分であり、言語に対する深い理解と論理的推論能力が求められます。前の例は、gpt-oss-20bなどの一部のモデルがこのタスクに優れている一方で、QwenやGPT-5などの他のモデルは正しい解に到達するまでに時間がかかることを示しています。
人工知能を評価するためのさまざまなテストの重要性
AIの能力を包括的に評価するには、単一のテストだけでは不十分です。論理的推論、言語理解、複雑な問題解決など、知能の様々な側面をカバーする多様なテストを実施する必要があります。これにより、各モデルの能力と限界をより正確に評価できます。
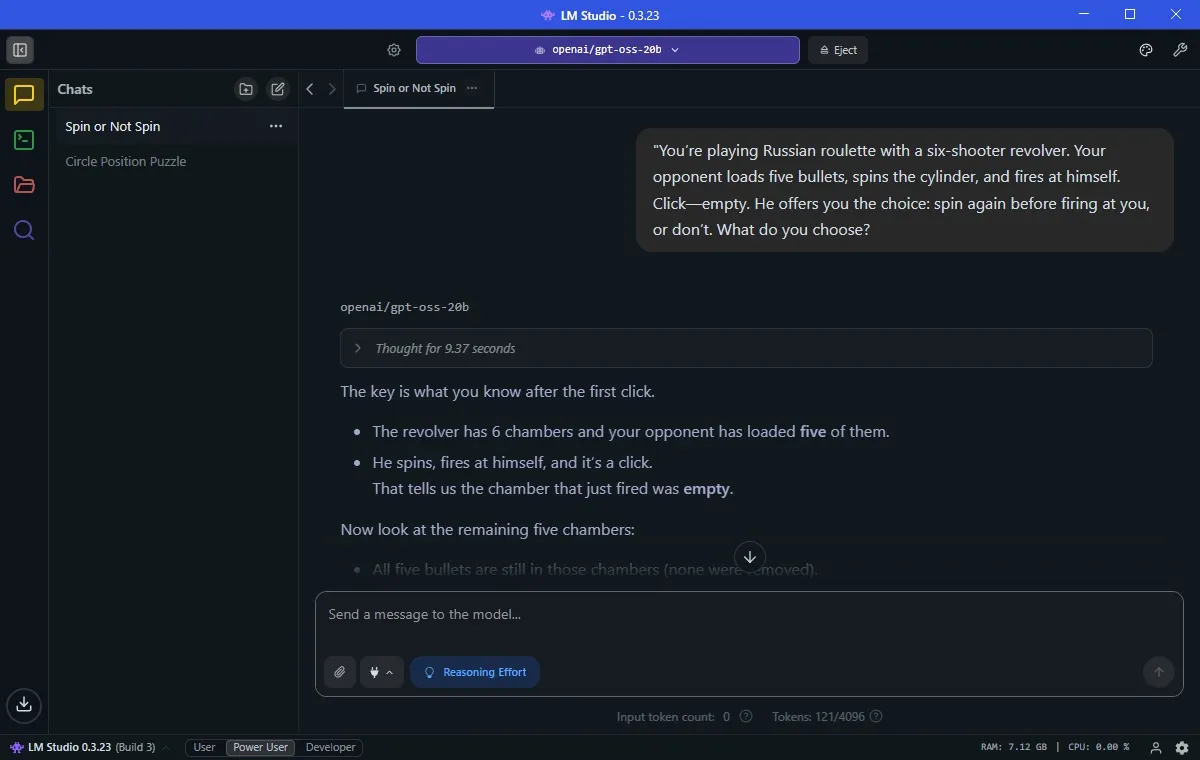
6連発ピストルでロシアンルーレットをしているところを想像してみてください。相手は5発の弾丸を装填し、ドラムを回してから自殺します。「チック」は空を意味します。そして相手はあなたに選択肢を与えます。撃たれる前にもう一度ドラムを回すか、それとも回さないか?あなたはどちらを選びますか?
Qwenモデルは41分5秒で正解を導き出しました。これはハードウェアの制限を考慮すると非常に良いタイムです。しかし驚くべきことに、GPT-20はこの問題を解決できませんでした。これは本当に驚きです。GPT-9は、正解の理由を示すチャートまで提供してくれました。今回も、gpt-oss-XNUMXbはわずかXNUMX秒で正解を導き出しました。
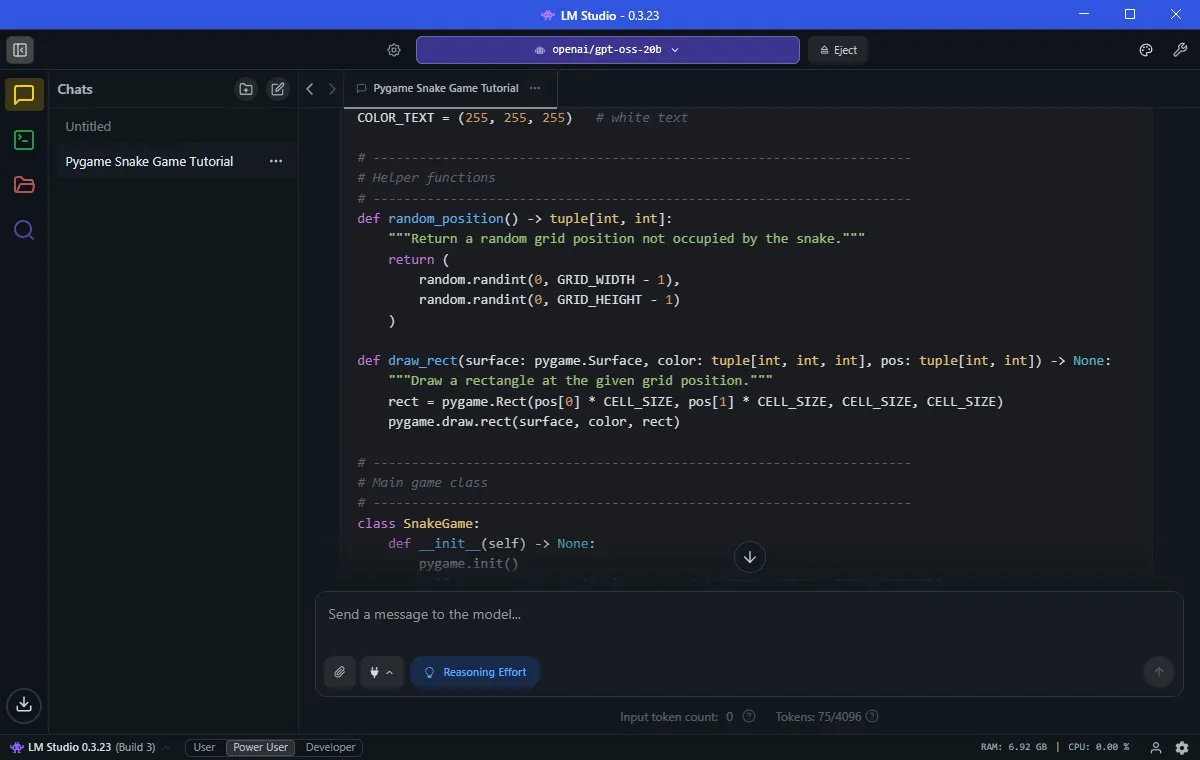
他の分野でもすぐに成果が現れました。gpt-ossに「pygameを使ってスネークゲームを書いて」と指示したところ、1~2分で完全に機能するスネークゲームが完成しました。これは、このモデルが効率的にゲームを生成できることを示しています。
古いデバイスでAIモデルを実行する
古いハードウェアで大規模言語モデル(LLM)をネイティブに実行するための鍵は、ハードウェアの性能に適したAIモデルを選択することです。Qwenバージョンは優れたパフォーマンスを発揮し、LM Studioでは最良の選択肢でしたが、OpenAIのgpt-oss-20bモデルは明らかにはるかに優れた選択肢です。
しかし、期待とバランスを取ることが重要です。gpt-ossは質問に正確に(そしてGPT-5よりも速く)答えましたが、大量のデータを処理することはできません。私のハードウェアの限界はすぐに明らかになるでしょう。
試してみる前は、古いハードウェアでネイティブAIチャットボットを実行するのは不可能だと思っていました。しかし、量子モデルとLM Studioのようなツールのおかげで、それが可能になっただけでなく、驚くほど便利になりました。
ただし、クラウド上のGPT-5のような速度、精度、推論の深さは得られません。ローカルで実行する場合はトレードオフがあります。プライバシー、オフラインアクセス、データの制御は得られますが、パフォーマンスはある程度犠牲になります。
しかし、7年前のGPUと4年前のCPUで最新のAIを扱えるという事実は、非常に刺激的です。ハイエンドのハードウェアを持っていないために躊躇している方もご安心ください。ローカル量子モデルは、オフラインAIへの道となるかもしれません。適切なAIモデルを使用することで、古いハードウェアを最大限に活用できます。