複雑で乱雑なスプレッドシートを長年扱ってきた結果、多くの人が手作業で行っている定型的な作業を自動化することで、毎週何時間もの作業を節約できるExcel関数を4つ発見しました。これらの関数は、プロのデータアナリストであれ、作業を簡素化したい一般ユーザーであれ、日常的にデータを扱う人にとって欠かせないものとなっています。

クイックリンク
4. XLOOKUP: スプレッドシートでの高度な検索
XLOKUP これは、Microsoft ExcelやGoogle Sheetsなどのスプレッドシートプログラムの高度な検索機能であり、次のような従来の検索機能の能力を超えています。 VLOOKUP و ルックアップ. タフ XLOKUP 柔軟性の向上、データ処理の効率化、従来の機能に関連する一般的なエラーの削減を実現します。 XLOKUP 金融アナリスト、データサイエンティスト、そして大量のデータを扱い、特定の情報を迅速かつ正確に抽出する必要があるすべての人にとって必須のツールです。 XLOKUP特定の範囲内の値を検索し、列や行の位置に関係なく、別の範囲から対応する値を返すことができます。また、 XLOKUP 右から左、下から上に検索するため、他の機能よりも汎用性があります。
VLOOKUPに別れを告げよう: XLOOKUPこそが完璧な解決策
何年も前にXLOOKUPを発見して以来、VLOOKUPを使うのをやめました。VLOOKUPは右方向しか検索できず、列を移動するとクラッシュしますが、XLOOKUPはどの方向にも検索でき、柔軟性も保っています。XLOOKUPは 時間を節約できるExcel関数 スプレッドシート内の特定のデータを検索します。
コンピューター部品の価格データで、製品モデルごとに特定のGPUの価格を調べる必要があります。VLOOKUP関数を使うと、テーブル全体を再構築する必要があります。しかし、XLOOKUP関数を使えば、次のように入力するだけで済みます。
=XLOOKUP("GIGABYTE GeForce RTX 3060 12GB ゲーミング OC", C:C, D:D)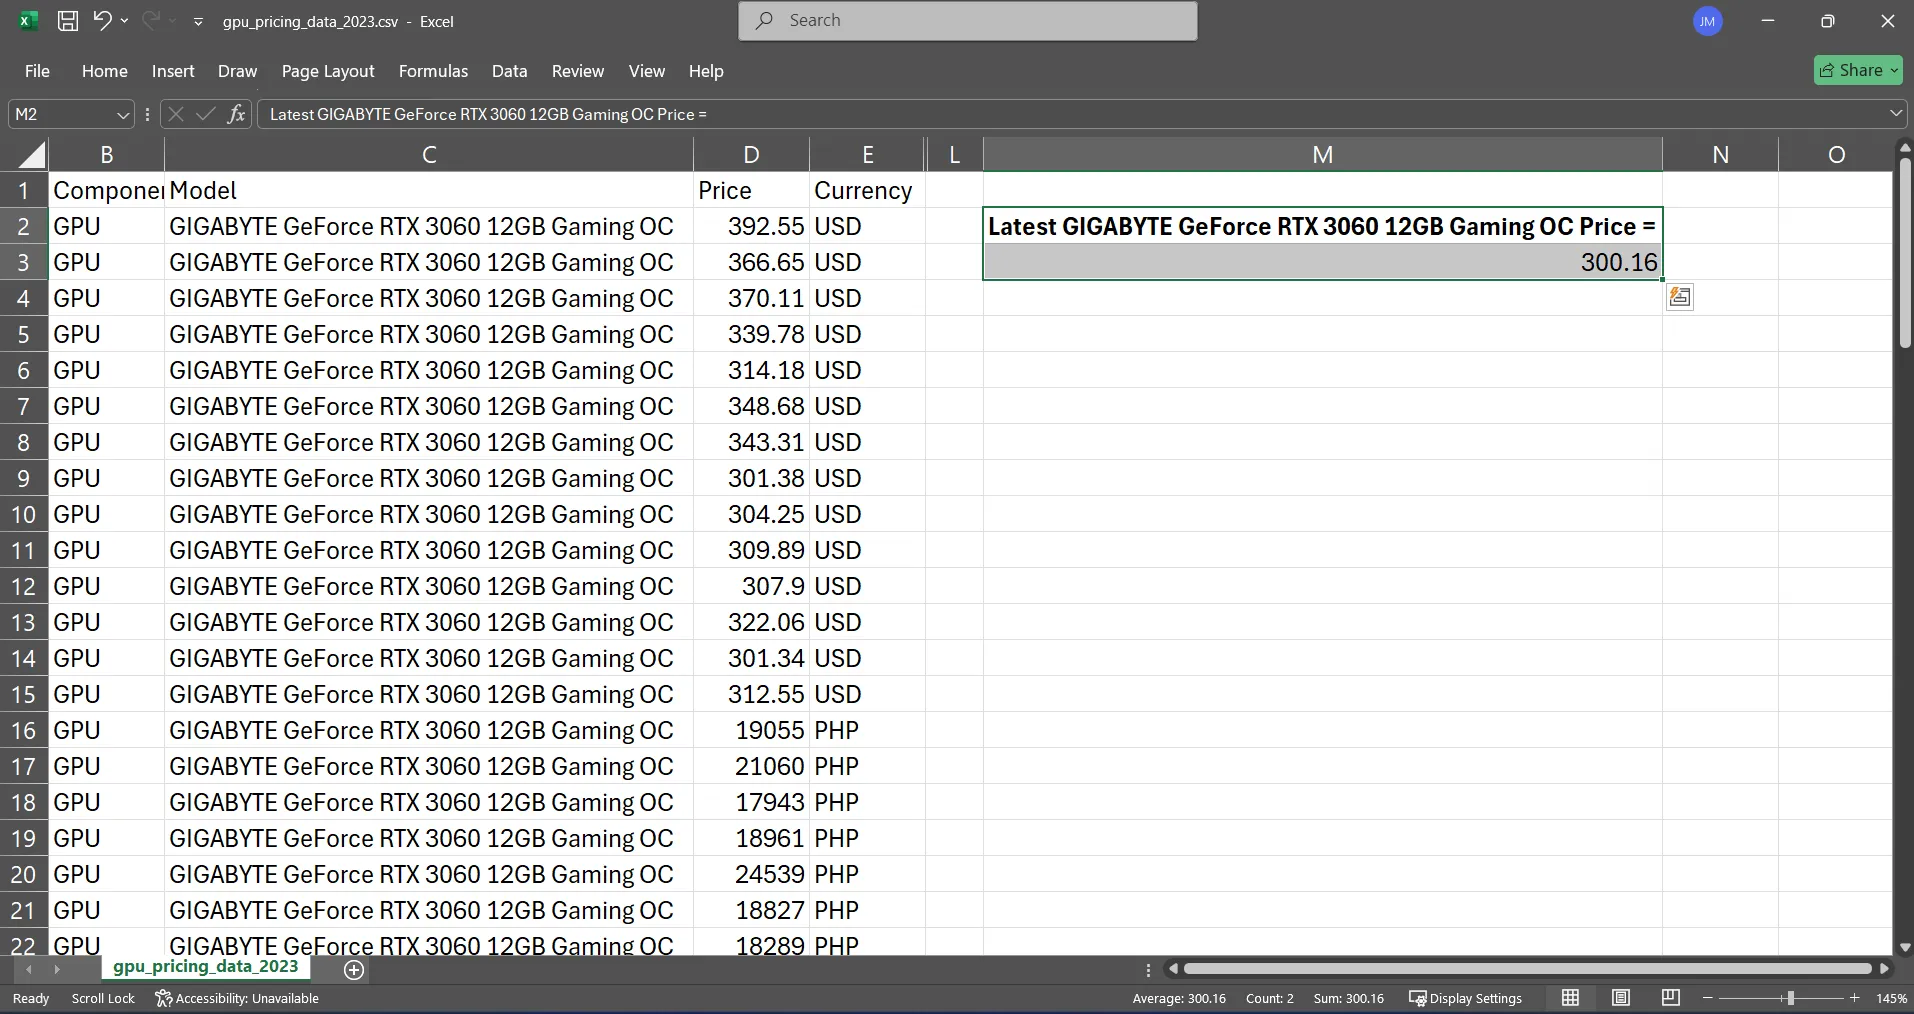
XLOOKUPは製品列全体を検索し、GPUを見つけて対応する価格を返します。価格列の位置は関係なく、後から列を追加してもクラッシュしません。私はいつもこの関数を使って、異なるシート間で製品情報を参照しています。フォーマットを変更する必要もありません。
XLOOKUP の基本的な数式は次のとおりです。
=XLOOKUP(検索値, 検索配列, 戻り配列)
- 参照値: 検索する値。
- lookup_array: 価値を探す場所。
- 戻り配列: 返したい値が含まれている列または行。
つまり、私の場合、見つけたかった値は「GIGABYTE GeForce RTX 3060 12GB Gaming OC」でした。この値をC:C列で検索し、一致が見つかった同じ行のD:Dから対応する値を返したいと考えました。
XLOOKUPのもう一つの優れた点は、数式の末尾に「,-1」を追加すると、下から上へと検索が実行され、最新の価格エントリが自動的に見つかることです。これにより、スプレッドシートを更新するたびに手動でデータを並べ替える必要がなくなります。
3. 私の関数を使う SUMIFS و COUNTIFS スプレッドシートで
複数の基準を専門的に扱う
基本的なSUM関数とCOUNT関数は単純なタスクには十分ですが、実際の分析には不十分です。複数の条件で価格データを分析する必要がある場合は、通常、SUMIFS関数とCOUNTIFS関数を使用します。これらの関数を使用すると、数百行のデータをセグメント化できます。



例えば、Amazon USで入手可能なAMDプロセッサの数を数えたいとします。手動でフィルタリングする代わりに、次のように入力します。
=COUNTIFS(F:F, "Amazon US", K:K, "AMD")
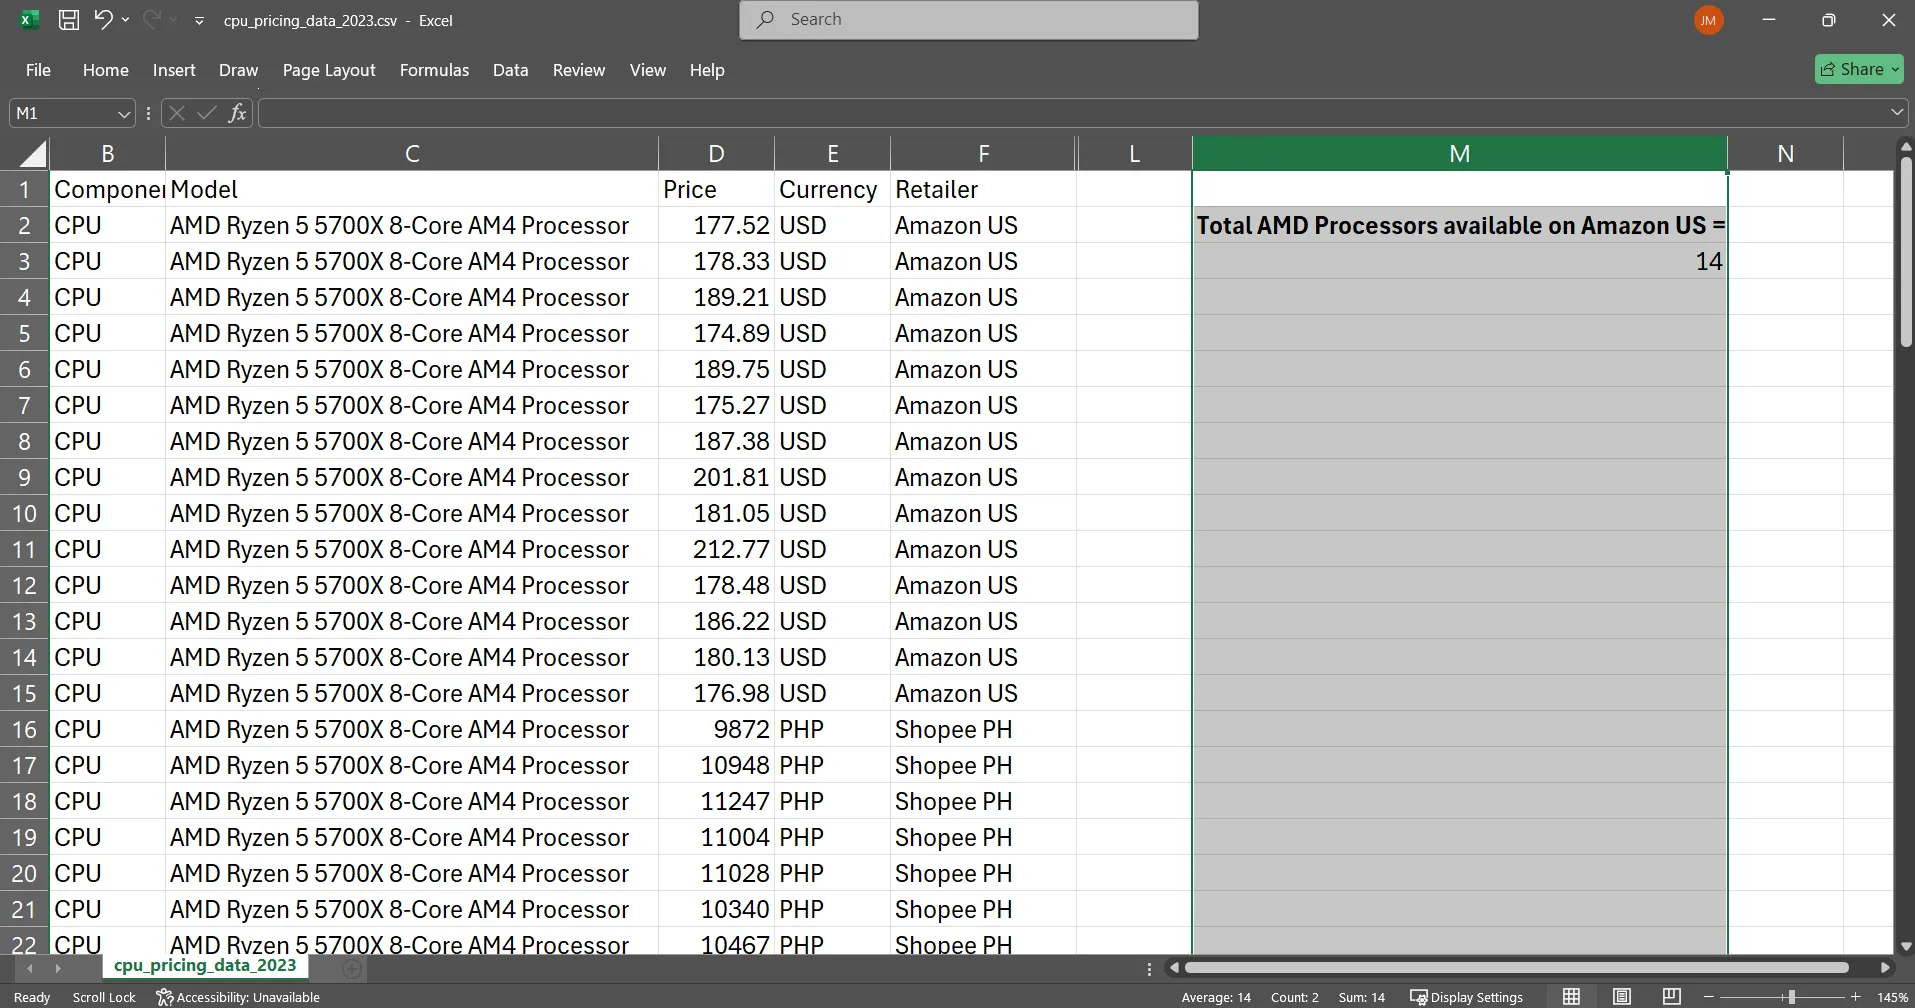
すると、私のデータセットにはAmazonに掲載されているAMDプロセッサが14個あることがすぐにわかります。この機能の素晴らしい点は、必要なだけベンチマークをコンパイルできることです。
価格分析では、SUMIFS関数は同様に機能します。現在在庫にあるすべてのIntelプロセッサの合計価値を計算するには、次のようにします。
=SUMIFS(D:D, K:K, "Intel", G:G, "在庫あり")
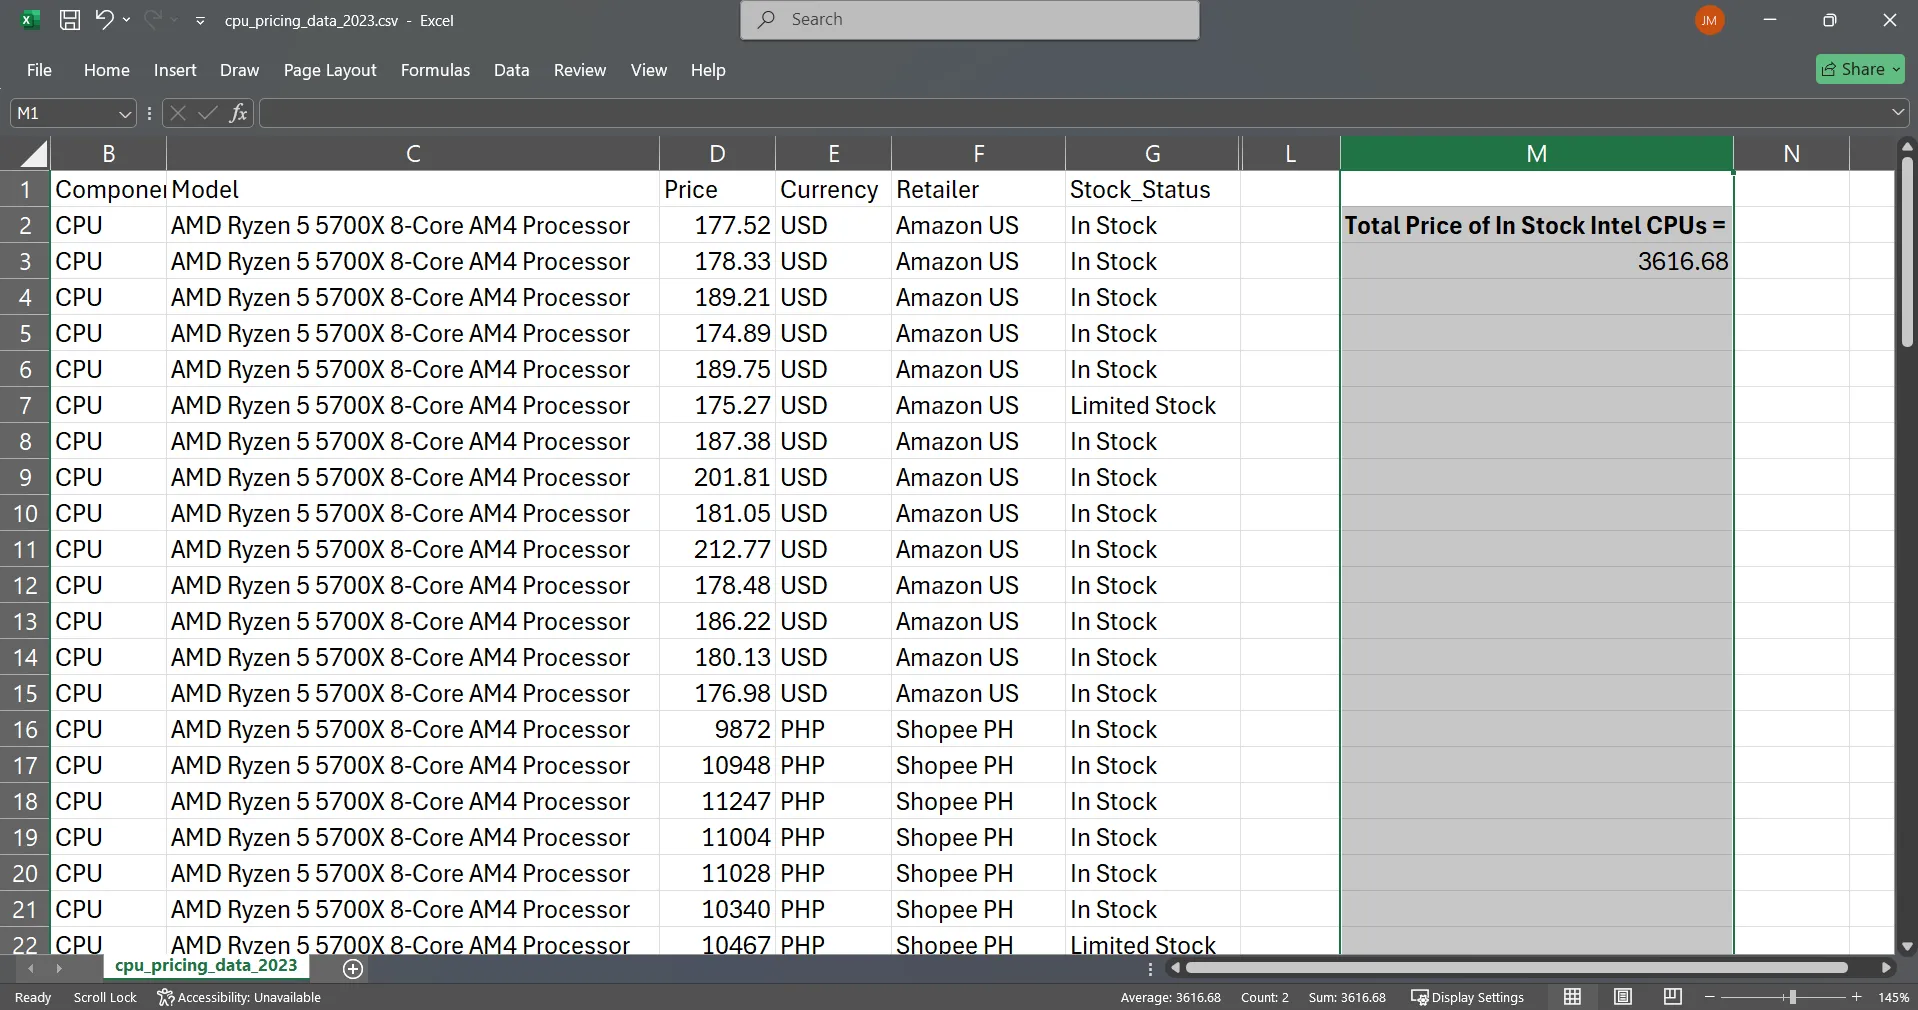
これにより、ブランドが「Intel」で在庫状況が「在庫あり」である列 D のすべての価格が追加されます。
SUMIFS 関数の構文は次のとおりです。
=SUMIFS(合計範囲, 条件範囲1, 条件1, 条件範囲2, 条件2...)
- 合計範囲: 合計する列。
- 基準範囲1: 条件をチェックする最初の列。
- 基準1: 最初の範囲条件。
- 条件範囲2、条件2: 追加の利用規約(オプション)。
COUNTIFS 関数も同様に動作しますが、値を合計するのではなく、一致する行をカウントする点が異なります。
=COUNTIFS(条件範囲1, 条件1, 条件範囲2, 条件2...)
SUMIFS関数とCOUNTIFS関数は、新しいデータが即座に更新され、既存の数式にうまく収まり、別途ピボットテーブルを作成することなくすべてのデータをインラインで管理できるため、簡単なレポート作成には最適です。これらのツールは、正確かつ効率的なデータ分析を可能にし、複雑なレポート作成にかかる時間と労力を節約します。SUMIFS関数やCOUNTIFS関数のような関数の使用は、データから貴重な洞察を迅速かつ容易に抽出したいすべてのデータアナリストにとって必須のスキルです。
2. トリミングとクリーニング:外観を維持するための必須ステップ
データの乱雑さよなら
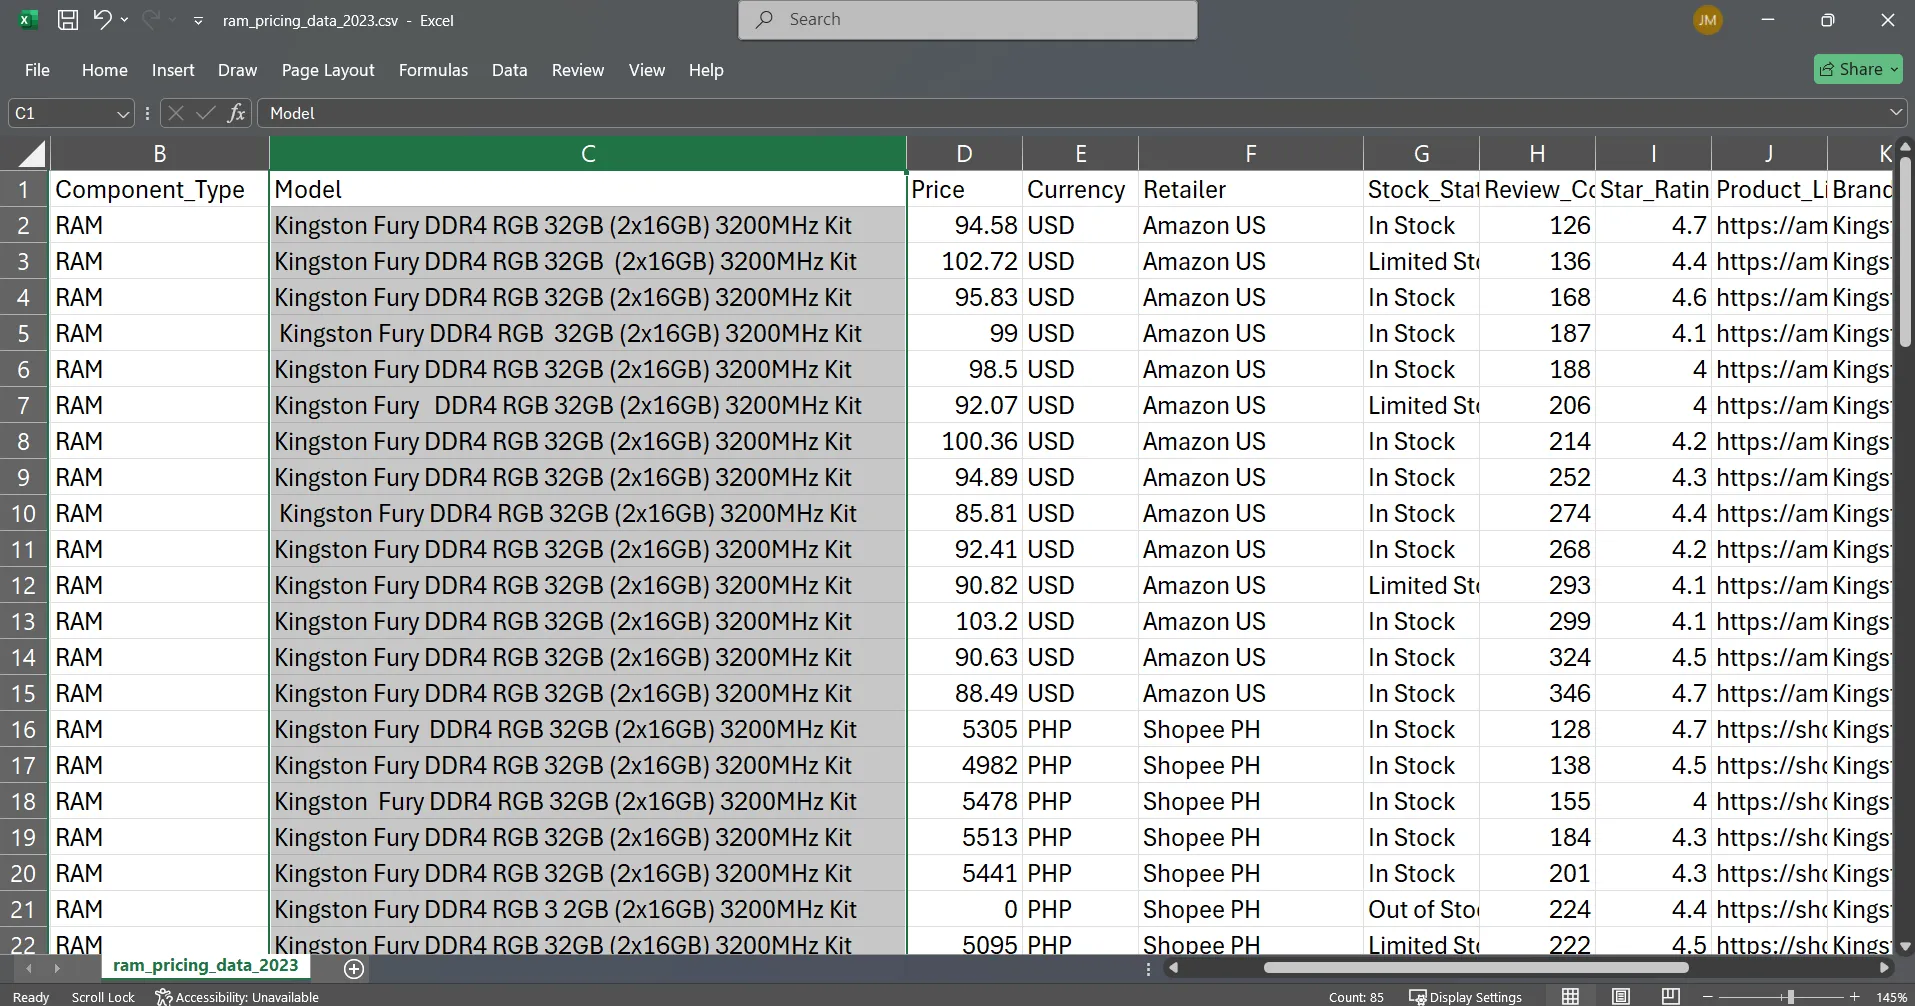
余分なスペースや隠し文字で埋め尽くされた非構造化データほど、スプレッドシートを台無しにするものはないでしょう。フォーム名の末尾に余分なスペースが入っているせいで、検索が何度も失敗し、私はそのことを身をもって学びました。
TRIM関数は、テキストの先頭と末尾の余分なスペース、そして単語間の余分なスペースを削除します。異なるソースからデータをインポートすると、商品名に一貫性のないスペースが含まれていることがよくあります。各セルを手動でクリーンアップする代わりに、補助列を作成して次のように使用します。
=トリム(C2)
次に、マウス ポインターをセルの端に移動してプラス記号 (+) に変わったら、TRIM 関数を実行するすべての行までドラッグします。
1. TEXTBEFOREとTEXTAFTER:詳細な説明と重要性
必要なデータを正確に抽出する
TEXTBEFORE関数とTEXTAFTER関数は、乱雑なスプレッドシートを整理するのに私が最も気に入っているExcel関数の一つです。Excelの最新のテキスト関数は、構造化されていない文字列から特定の情報を抽出するのに優れています。例えば、価格の列には「$177.52」「178.33 USD」「₱9055」「9645.50 PHP」といった文字列が混在していました。
TEXTBEFORE 関数は、指定された区切り文字の前にあるすべてのものを抽出します。
=TEXTBEFORE(D2, "USD")
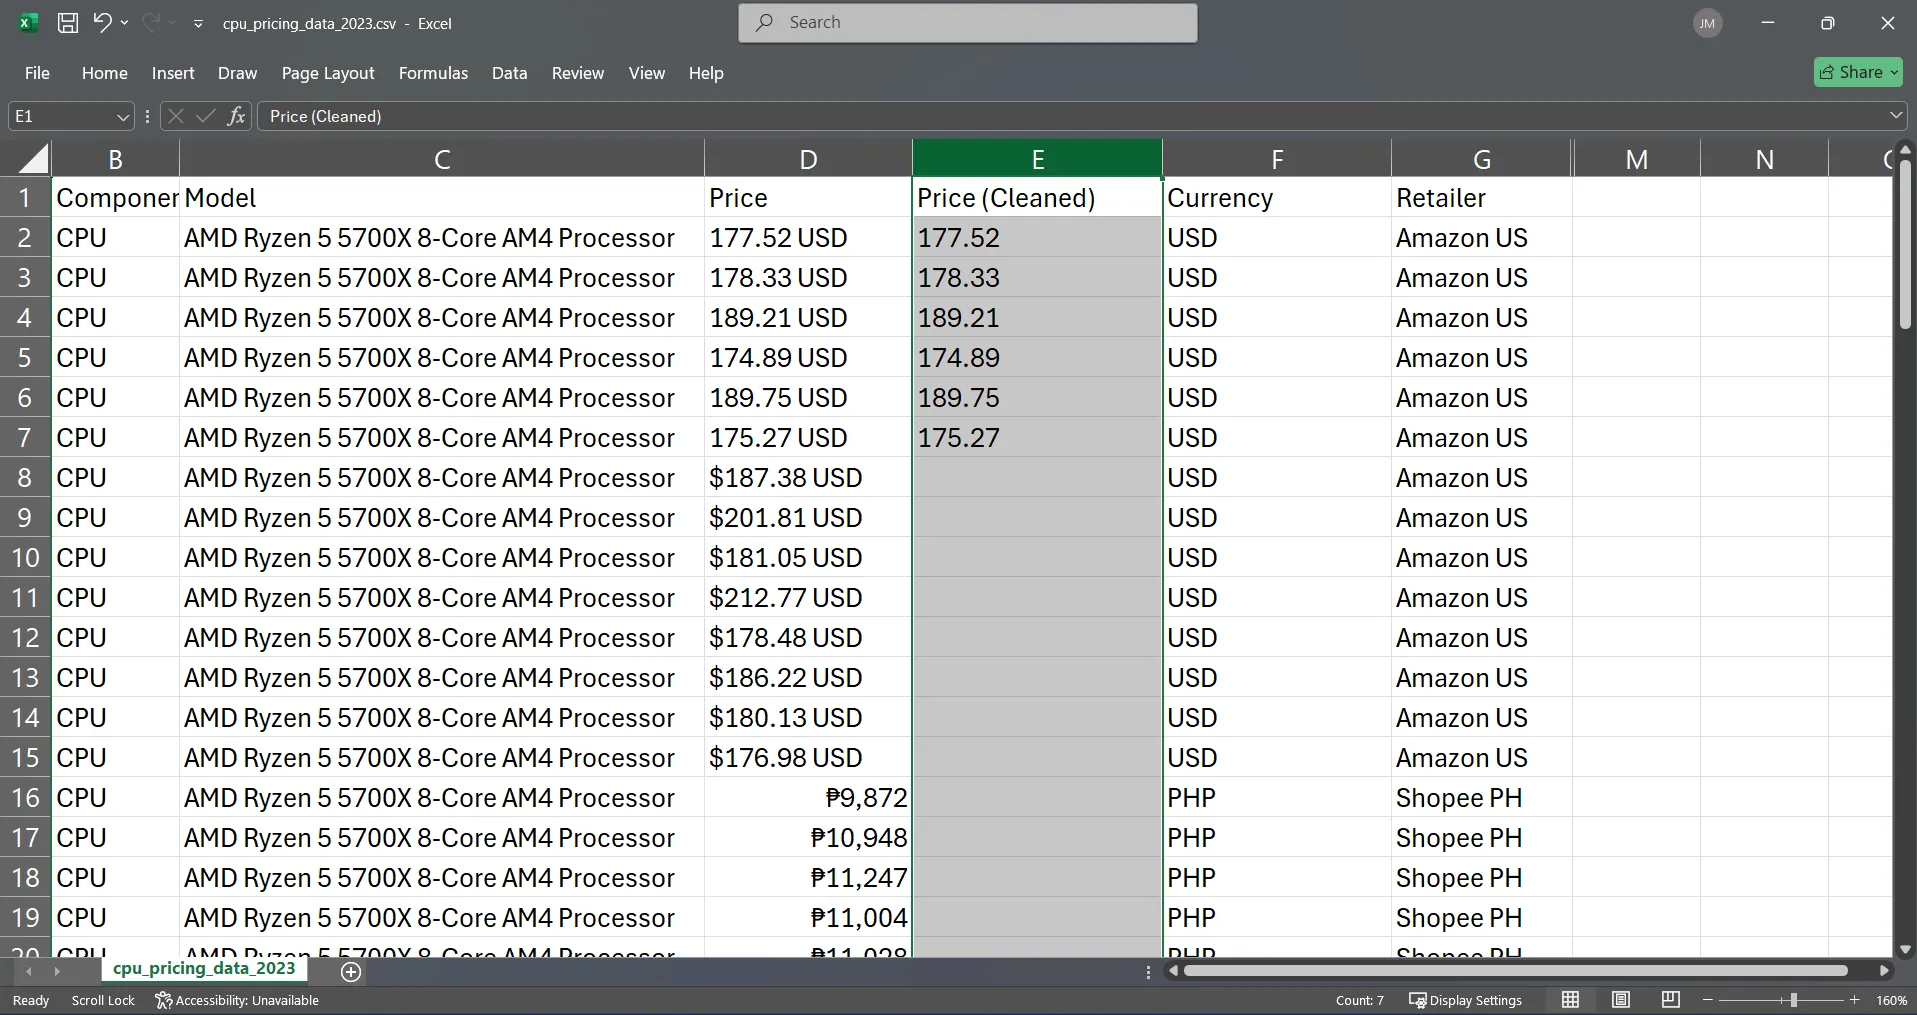
この方法では、関数は「178.33 USD」から「178.33」を瞬時に抽出しました。
TEXTAFTER 関数は逆に動作し、区切り文字の後のすべてを抽出します。
=TEXTAFTER(C2, "AMD ")
このようにして、「AMD Ryzen 5 5700X 8-Core AM4 Processor」から「Ryzen 5 5700X 8-Core AM4 Processor」という機能を抽出しました。
複雑な抽出には、両方の関数を組み合わせます。177.52ドルという数値価格を取得するには、次のようにします。
=TEXTBEFORE(TEXTAFTER(D8, "$"), "USD")
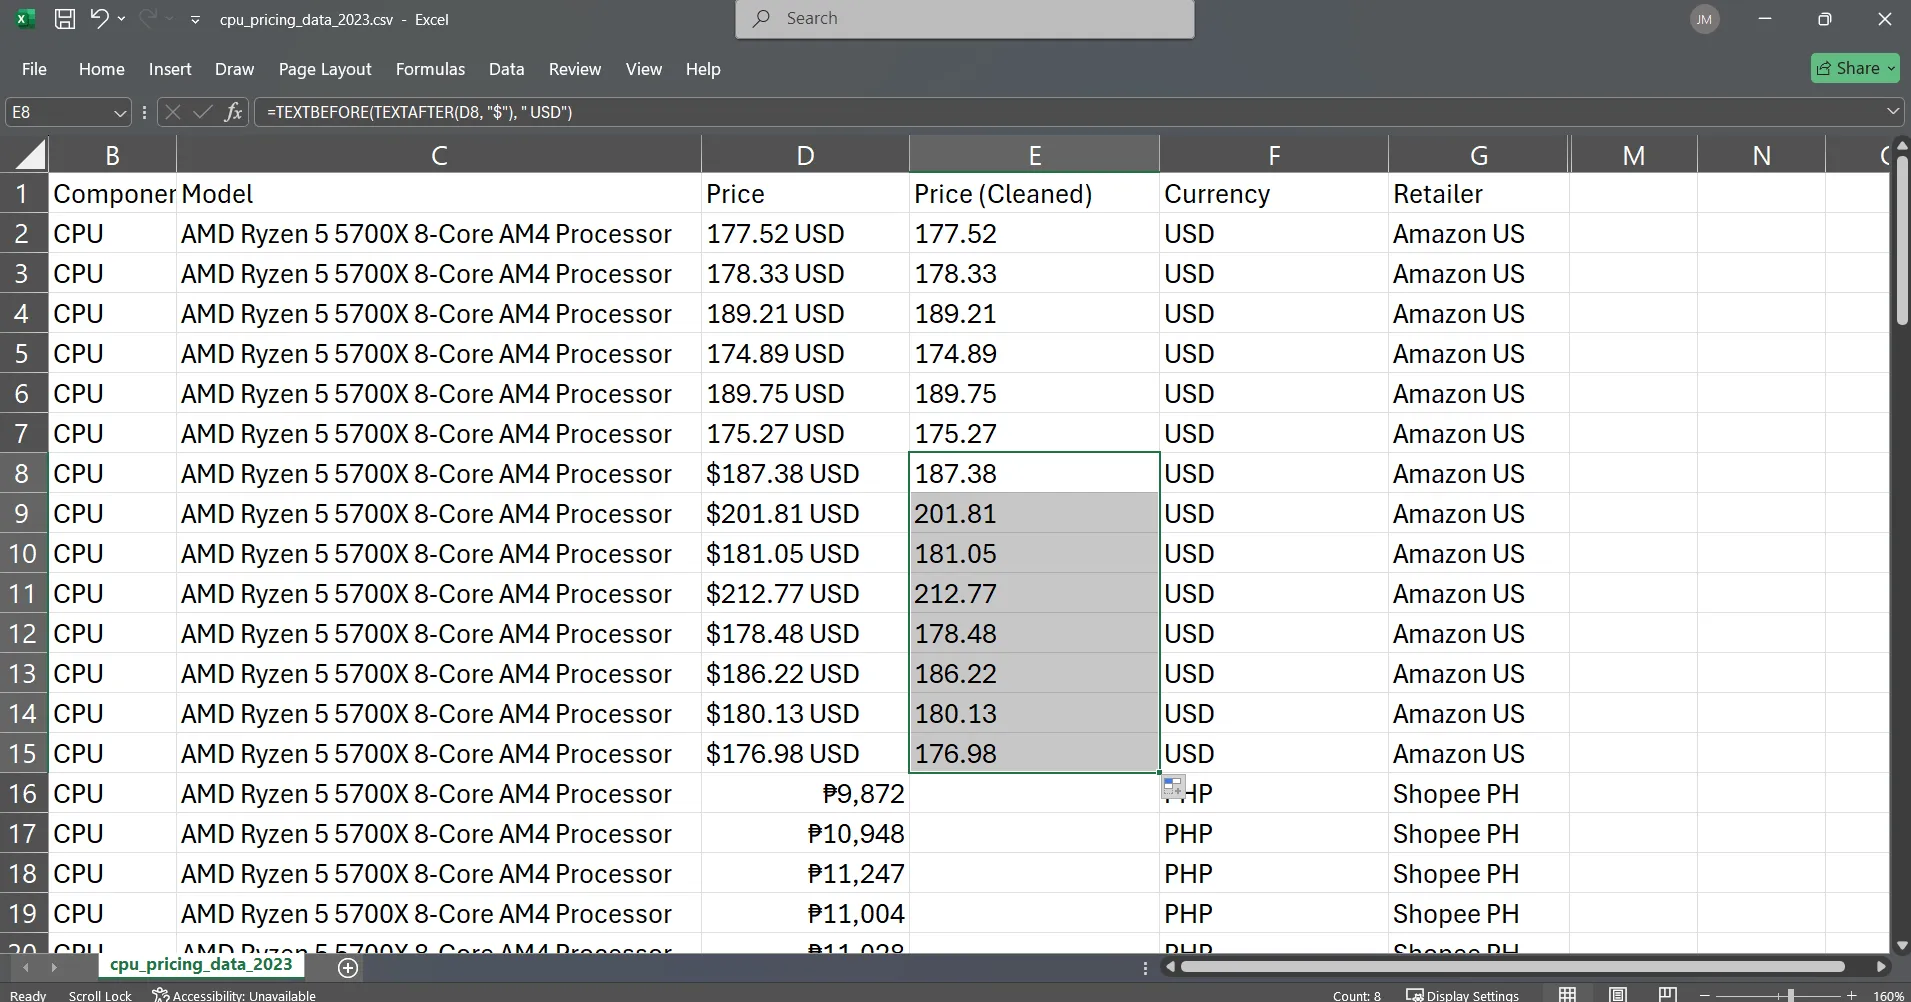
TEXTBEFORE 関数と TEXTAFTER 関数の一般的な構文は次のとおりです。
=TEXTBEFORE(テキスト, 区切り文字) と =TEXTAFTER(テキスト, 区切り文字)
これら2つの関数がもたらす大きな改善点は、その精度にあります。MID、FIND、LEN関数を複雑に組み合わせる代わりに、シンプルで読みやすい数式を使って、クリーンな抽出を実現できます。私はこれらの関数を頻繁に使用し、型番の分離、製品仕様の抽出、そして以前は何時間もかけて手作業で編集していたインポートテキストからのクリーンなデータの抽出を行っています。
これら4つの関数は、Excelで最も時間を浪費するいくつかの問題に対応します。例えば、柔軟な検索を使用したデータの検索、複数の条件に基づく分析、乱雑なインポートテキストのクリーンアップ、複雑な文字列からの特定の情報の抽出などです。多くの人はこれらのタスクを手作業で処理しており、通常は数分で正しい数式を実装できる作業に何時間も費やしています。
これらの関数は、部品の価格分析から在庫管理レポートまで、あらゆる場面で活用されています。乱雑なデータや複雑な検索要件は、業界を問わず普遍的な問題です。これらの関数をマスターすれば、これまでスプレッドシートをこれらなしで管理していたことが不思議に思えるでしょう。